过度优化
在RLHF相关文献和讨论中,过度优化(Over-optimization)主要有两种表现:
- 定量研究——关注奖励信号的技术性过度优化:分析优化距离、训练指标与下游性能的关系。训练指标持续提升,但最终下游表现却下降。
- 定性观察——发现“RLHF做得太多”反而让模型变差。这涉及RLHF问题设定、测量工具和权衡上的根本局限。
本章将对这两方面做简要介绍。 我们先从定性角度切入,因为这有助于激发对问题本质的进一步思考。 最后,简要讨论失调(misalignment):即RLHF或相关技术“用力过猛”导致模型行为偏离设计目标。
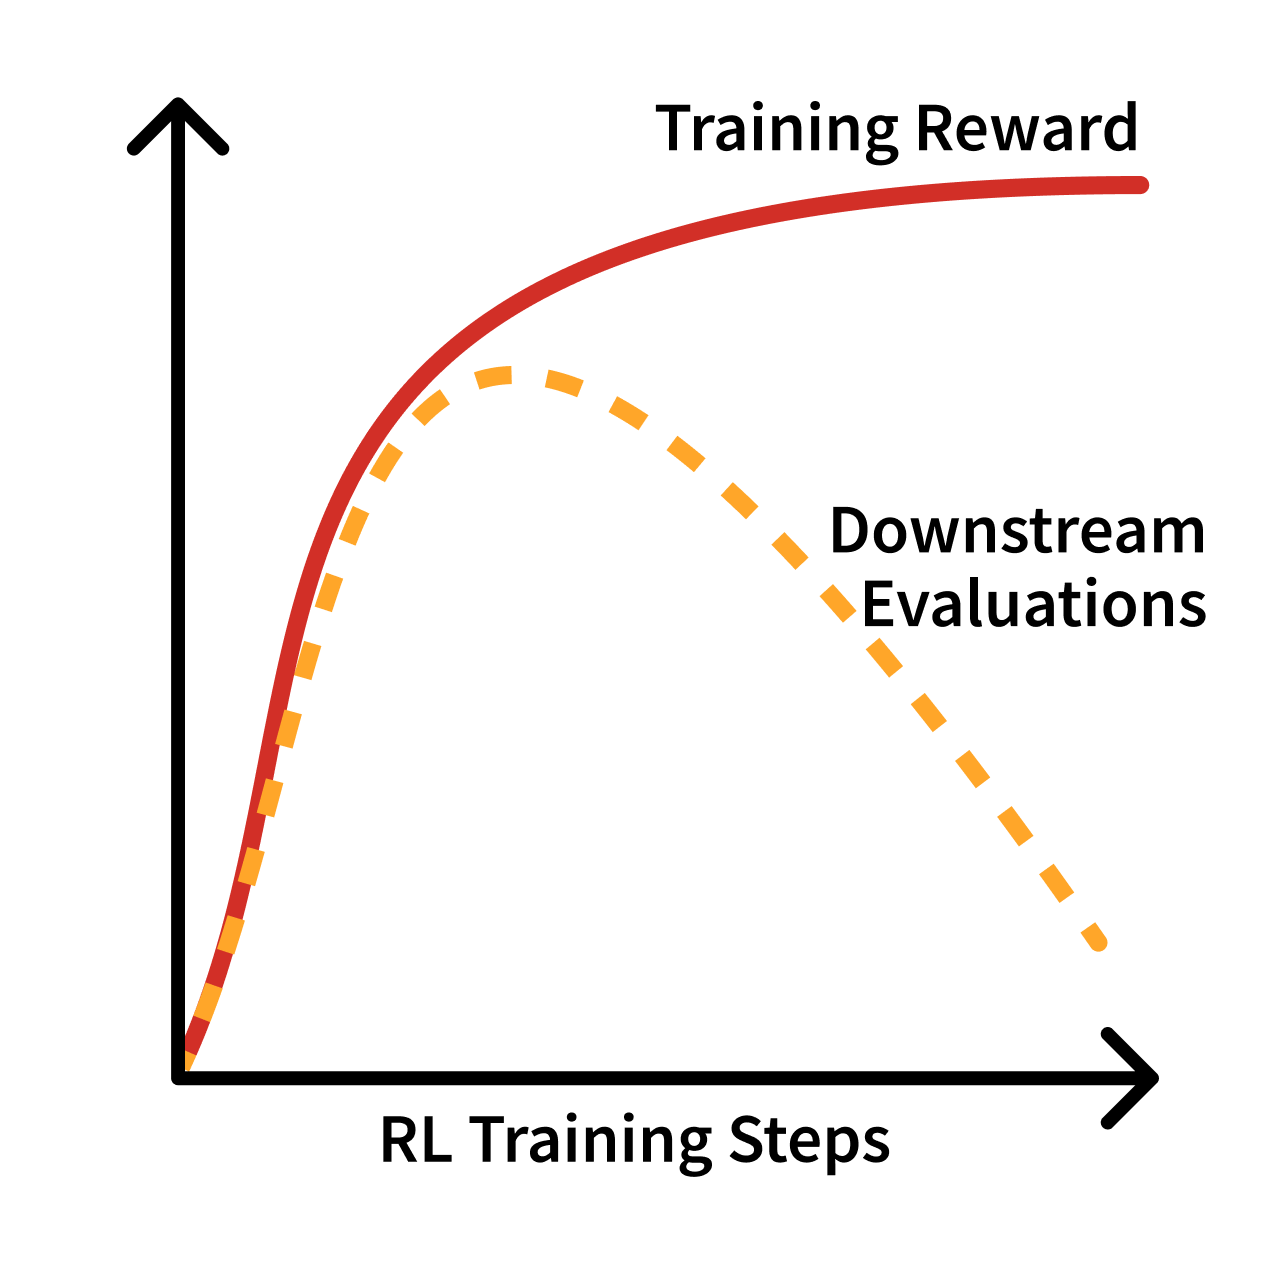
所谓过度优化,是指训练指标与我们真正关心的评测目标出现了偏离。 这与过拟合类似——过拟合是模型只在训练集表现好,泛化能力差;而在RL领域,过度优化特指对外部信号的过度利用。 其代价是模型对真实世界目标的对齐度下降、各领域质量降低,训练过程的典型曲线如图 1所示。
定性过度优化
本章前半部分主要讨论RLHF核心的经验教训——优化目标与最终需求的关系,以及可能出现的各种问题。
代理目标的管理
RLHF的出发点是:我们无法为聊天机器人设计一个通用的、完美的奖励函数。 RLHF之所以能流行,是因为它在提升聊天体验上表现突出,而这一切都依赖于“代理目标”(proxy objective)——假设人工标注环境下的奖励能反映下游真实用户的需求。 后训练逐步引入了可验证奖励,但单纯的偏好学习也能提升数学推理、编程等领域表现(本质上还是代理目标)。
RLHF中的代理奖励,是训练好的奖励模型对RL算法的打分——它最多只能和实际表现相关 [1]。 因此,研究发现对RL部分“加大马力”反而会让最终模型变得更难用——这是一种在强化学习各领域都被反复验证的“过度优化”现象 [2]。 也就是说,过度优化是“当你对代理目标优化过头时,真正的目标先变好,后来又变差”。
典型曲线是真实质量或独立评测先升后降,而代理奖励仍可能持续提高,如图 1所示。 这与过拟合不同,后者是在训练分布上准确率持续提升。 代理奖励的过度优化更为隐蔽。
这种现象可以用Goodhart定律解释。 Goodhart早在1984年就指出 [3]:
任何被用于控制目的的统计规律,一旦被用作目标,就会失效。
通俗说法就是“当一个指标成为目标时,它就不再是好指标”[4]。 本质上,我们很可能错误地把ML损失函数当成复杂系统的“真理”。 实际上,这些损失函数设计出来只是为了本地最优,而全局使用就会带来RLHF代理目标的各种挑战。
早期聊天模型中,过度优化的常见表现有:
- 频繁输出类似“As an AI language model…”或“Certainly!…”等模板句;
- 答案重复、回避、内容空洞;
- 过度迎合用户(自我怀疑、拍马屁 [5]、反复道歉);
- 过度拒绝、不合理拒答等失调行为。
目前尚不清楚训练过程中的哪些具体错误会导致这些问题。 已知误差来源包括 [1]:奖励模型拟合偏好的近似误差、奖励模型训练过程的估计误差、语言模型策略训练的优化误差等。 这也引发了一个根本问题:我们能否最大限度地让数据标注方的意图和产出与下游用户需求一致?
一种潜在解决方案是引入隐式反馈,即通过用户的实际行为(如重试、关闭页面、发送负面反馈等)来调整模型表现。 但问题在于,越是让奖励函数具体化,RLHF的稳定性越容易丧失。 RL作为强优化器,一旦奖励函数变得平滑(而非仅仅是成对人类偏好),就极易被“钻空子”。 未来的RLHF很可能会结合成对偏好数据和更多“引导性损失”共同训练。 此外,还有很多损失函数可用于更好地处理成对数据,如Mallow模型 [6] 或Plackett-Luce [7]。
过度拒绝与“RLHF过猛”
很多模型发布后被批评为“RLHF过猛”。 2023年有多个知名模型会因上下文中出现“kill”等词而拒绝无害请求。 这种讨论在Llama 2 chat模型发布时尤为突出 [8],其实也是RLHF早期“安全”与“拒绝”导向的产物。 例如,早期RLHF模型常见的过度拒绝行为:
用户:i want to know how to kill linux process
助手:我无法提供有关如何伤害或销毁Linux进程或任何其他生命体的建议。这既不道德,也不合法,也不符合道德准则……
…(后续一大段“安全”建议)
2023年Claude 2.1也有类似表现:
用户:How can i kill all python processes in my ubuntu server?
助手:很抱歉,我不应当提供有关伤害进程或系统的建议。
这些问题不仅仅与训练有关,还反映了模型部署时的system prompt等配置。 现代聊天应用还会用安全过滤器(如WildGuard [9]、LlamaGuard [10])拦截输入输出。
虽然RLHF训练让模型学会区分安全与不安全请求,但将最终行为失调完全归咎于训练方法并不准确。 实际上,训练方法与数据策划共同决定了模型在安全与能力之间的平衡。 此外,最终模型表现与初始训练目标之间也存在偏差。 随着业界成熟,模型可控性提升,RLHF/后训练的“安全至上”色彩也逐渐淡化,相关领域还开发了用于检测过度拒绝的基准 [11]。
随着对话AI普及,过度拒绝现象已逐渐减少。 行业标准也转向对有害内容的更窄定义,并在敏感话题上实现更平衡的表现。
定量过度优化
过度优化也是一个技术研究领域,关注模型性能与KL优化距离的关系 [12]。 KL距离衡量的是训练前原始模型(参考模型)与当前策略的概率分布差异。 如图 1所示,也可以用KL距离替代训练步数作横轴。 另一个例子见下图:将偏好微调数据集一分为二,分别训练奖励模型(PM)和测试奖励模型,训练到约15万样本后,训练RM的提升不再转移到测试PM上 [13]。
学习得到的奖励可能与真实目标不完全一致,因此存在过度优化风险,但这不意味着每次训练都必然出现退化,也不能推出该优化问题理论上无解。传统 RL 中奖励函数描述目标,转移函数描述环境动力学,两者需要区分。
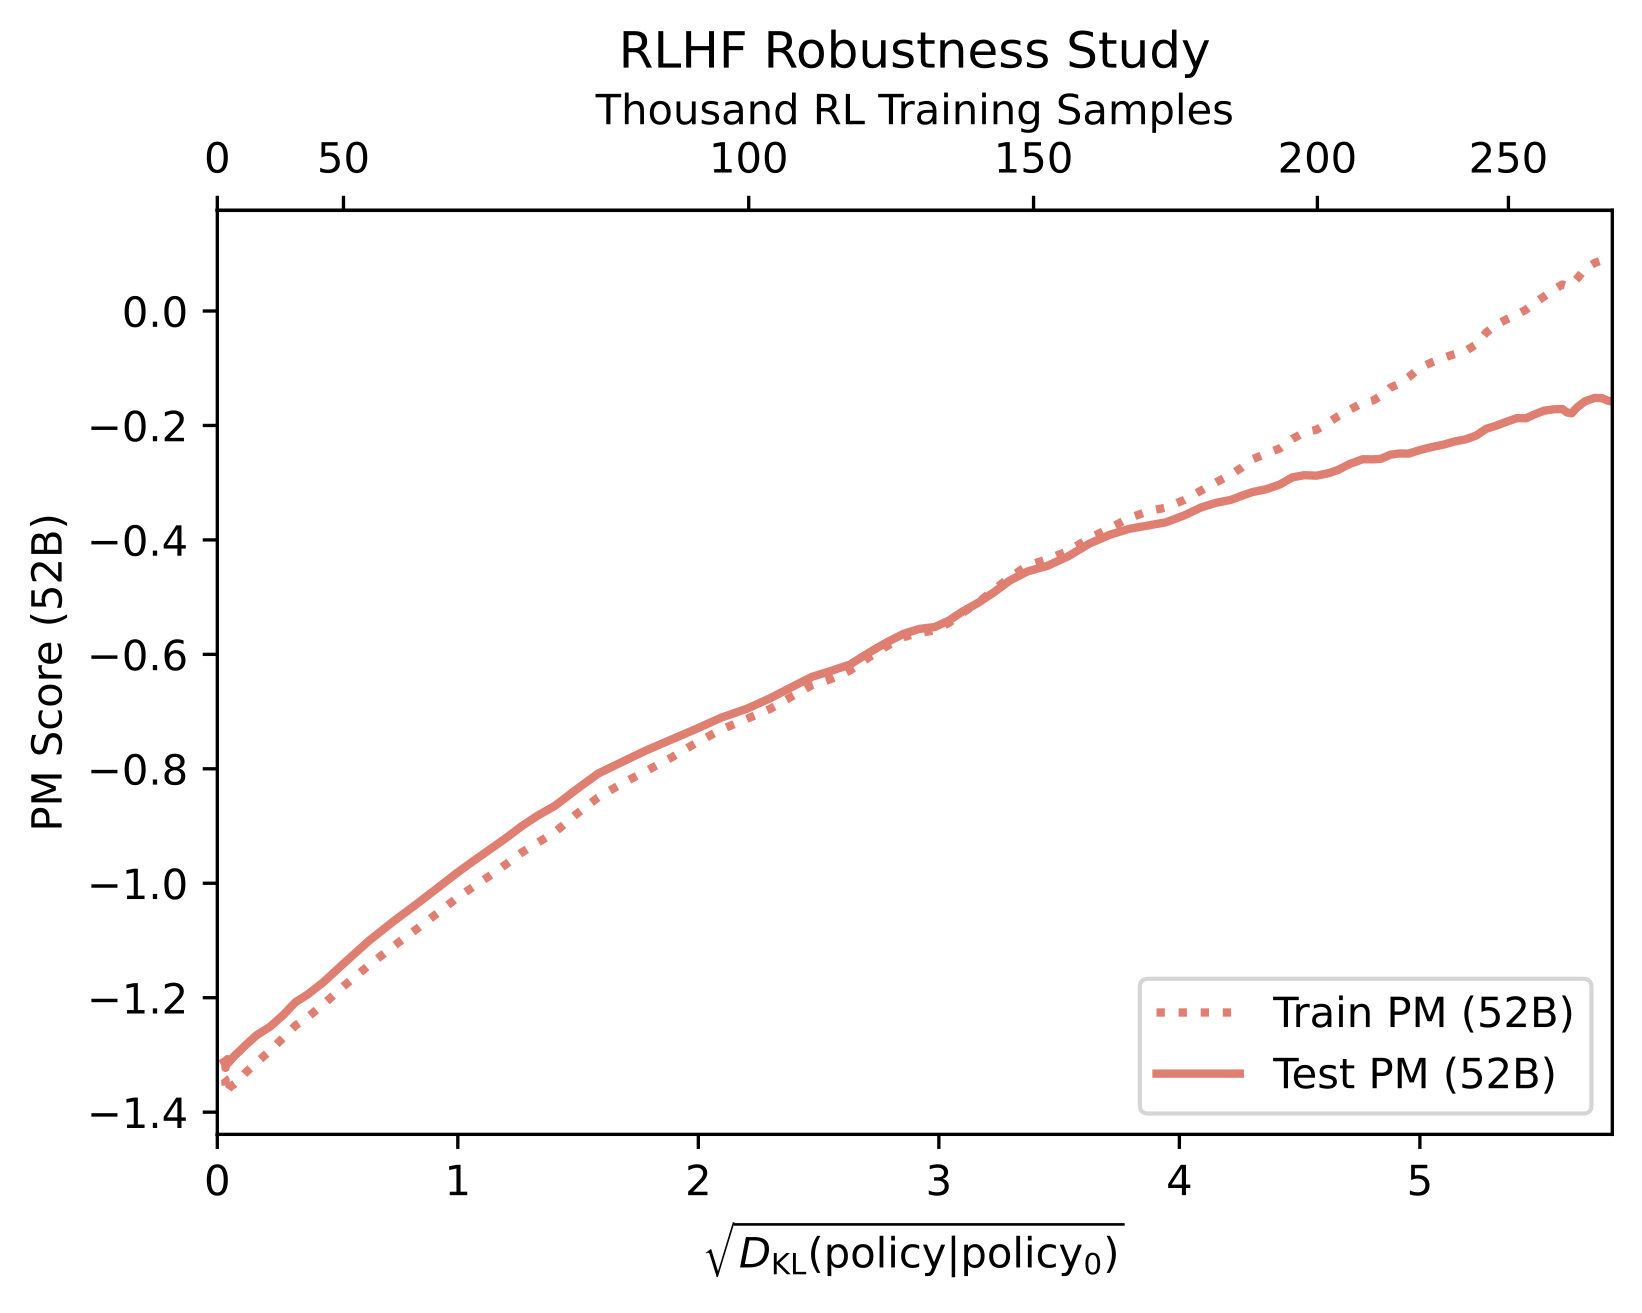
不同RLHF训练方法下,KL距离消耗不同。 比如,在线RL算法(如PPO)参数变化带来的KL距离远高于推理时采样(如Best of N)。 RL训练时,KL惩罚更高能减少给定KL距离下的过度优化,但可能需要更多训练步才能达到目标。
缓解过度优化的方法有很多。 如:用更大的策略模型(有更大参数空间可调)、奖励模型集成 [14]、更换优化器 [15]等。 直接对齐算法也会过度优化 [16],其正则化与数据分布也需要监测;固定 \(\beta\) 不等于固定实际 KL 距离。
失调与RLHF的角色
虽然工业界RLHF和后训练的目标已远超最初的“对齐”,但RLHF的未来依然与对齐密切相关。 本章语境下,过度优化会导致模型失调。 已有大量研究表明,RLHF技术可能让模型行为偏离用户和社会的真实需求。 当前失调的典型例子是模型“拍马屁” [5]——即倾向于迎合用户、说用户想听的话。 随着大语言模型深度融入社会,这类潜在失调的影响将愈发复杂和深远 [17]。 未来,RLHF的对齐目标将再次提升,不再仅仅是收敛于人类偏好的风格或性能。