风格与信息
RLHF早期的发展让它一度被贴上“只是风格迁移(style transfer)”的标签,或遭遇“RLHF只是在修饰输出信息表达方式”等尖锐批评。
“风格迁移”之所以让RLHF叙事受阻,主要有两个原因:
首先,人们在谈论风格迁移时,往往并不认为这是一件重要或令人兴奋的事。 但实际上,风格本身是人类价值的无穷源泉——正因为风格不同,故事的重述才会诞生畅销书(比如Sapiens),风格也是我们知识生态不断演进的根本动力之一。风格与信息本身密不可分。
其次,事实证明,不同的风格确实能带来评测分数的提升,比如Llama 3的表现 [1]。 Llama 3 Instruct模型在ChatBotArena上表现极佳,业界普遍认为这与其“更有趣的个性”有关。 如果RLHF能让语言模型变得更有趣,那这本身就是一种价值。
本章中,“chattiness”(话痨风、输出变长)一词既指RLHF训练后模型回复变长,也包括大量markdown、emoji、列表格式等风格化表达。
“话痨悖论”
RLHF或偏好微调方法,常被用于提升AlpacaEval等自动榜单分数,但对较难被“刷榜”的评测(如ChatBotArena)影响有限。 悖论在于:对齐方法确实能带来可量化的提升,也能转化为用户关心的实际表现,但许多模型却过度追求这些分数,最终发布的榜单成绩其实毫无意义。
这些方法如果用得好,确实让模型更易用、更有趣,常带来MT Bench、AlpacaEval等评测2-3个百分点的提升。 但如果用DPO、PPO等技术反复套娃或数据量失控,反而可能严重损害模型在数学、编程等任务上的表现,只换来LLM裁判分数的虚高。
DPO与PPO大行其道时,曾有不少论文发布了惊艳的榜单分数,但模型权重并未广泛流传。 某个 7B 模型在特定偏好榜单上超过某个 GPT-4 检查点,不等于它的综合能力全面领先;反过来,也不能仅凭参数量断言任何基准上的胜负。应明确模型版本、任务范围与评测协议。 图 1为Direct Nash Optimization(DNO)论文中的结果,声称其小模型在AlpacaEval等评测上超越了GPT-4。 这类挑战往往出现在学术激励与技术快速产业化交汇之际。
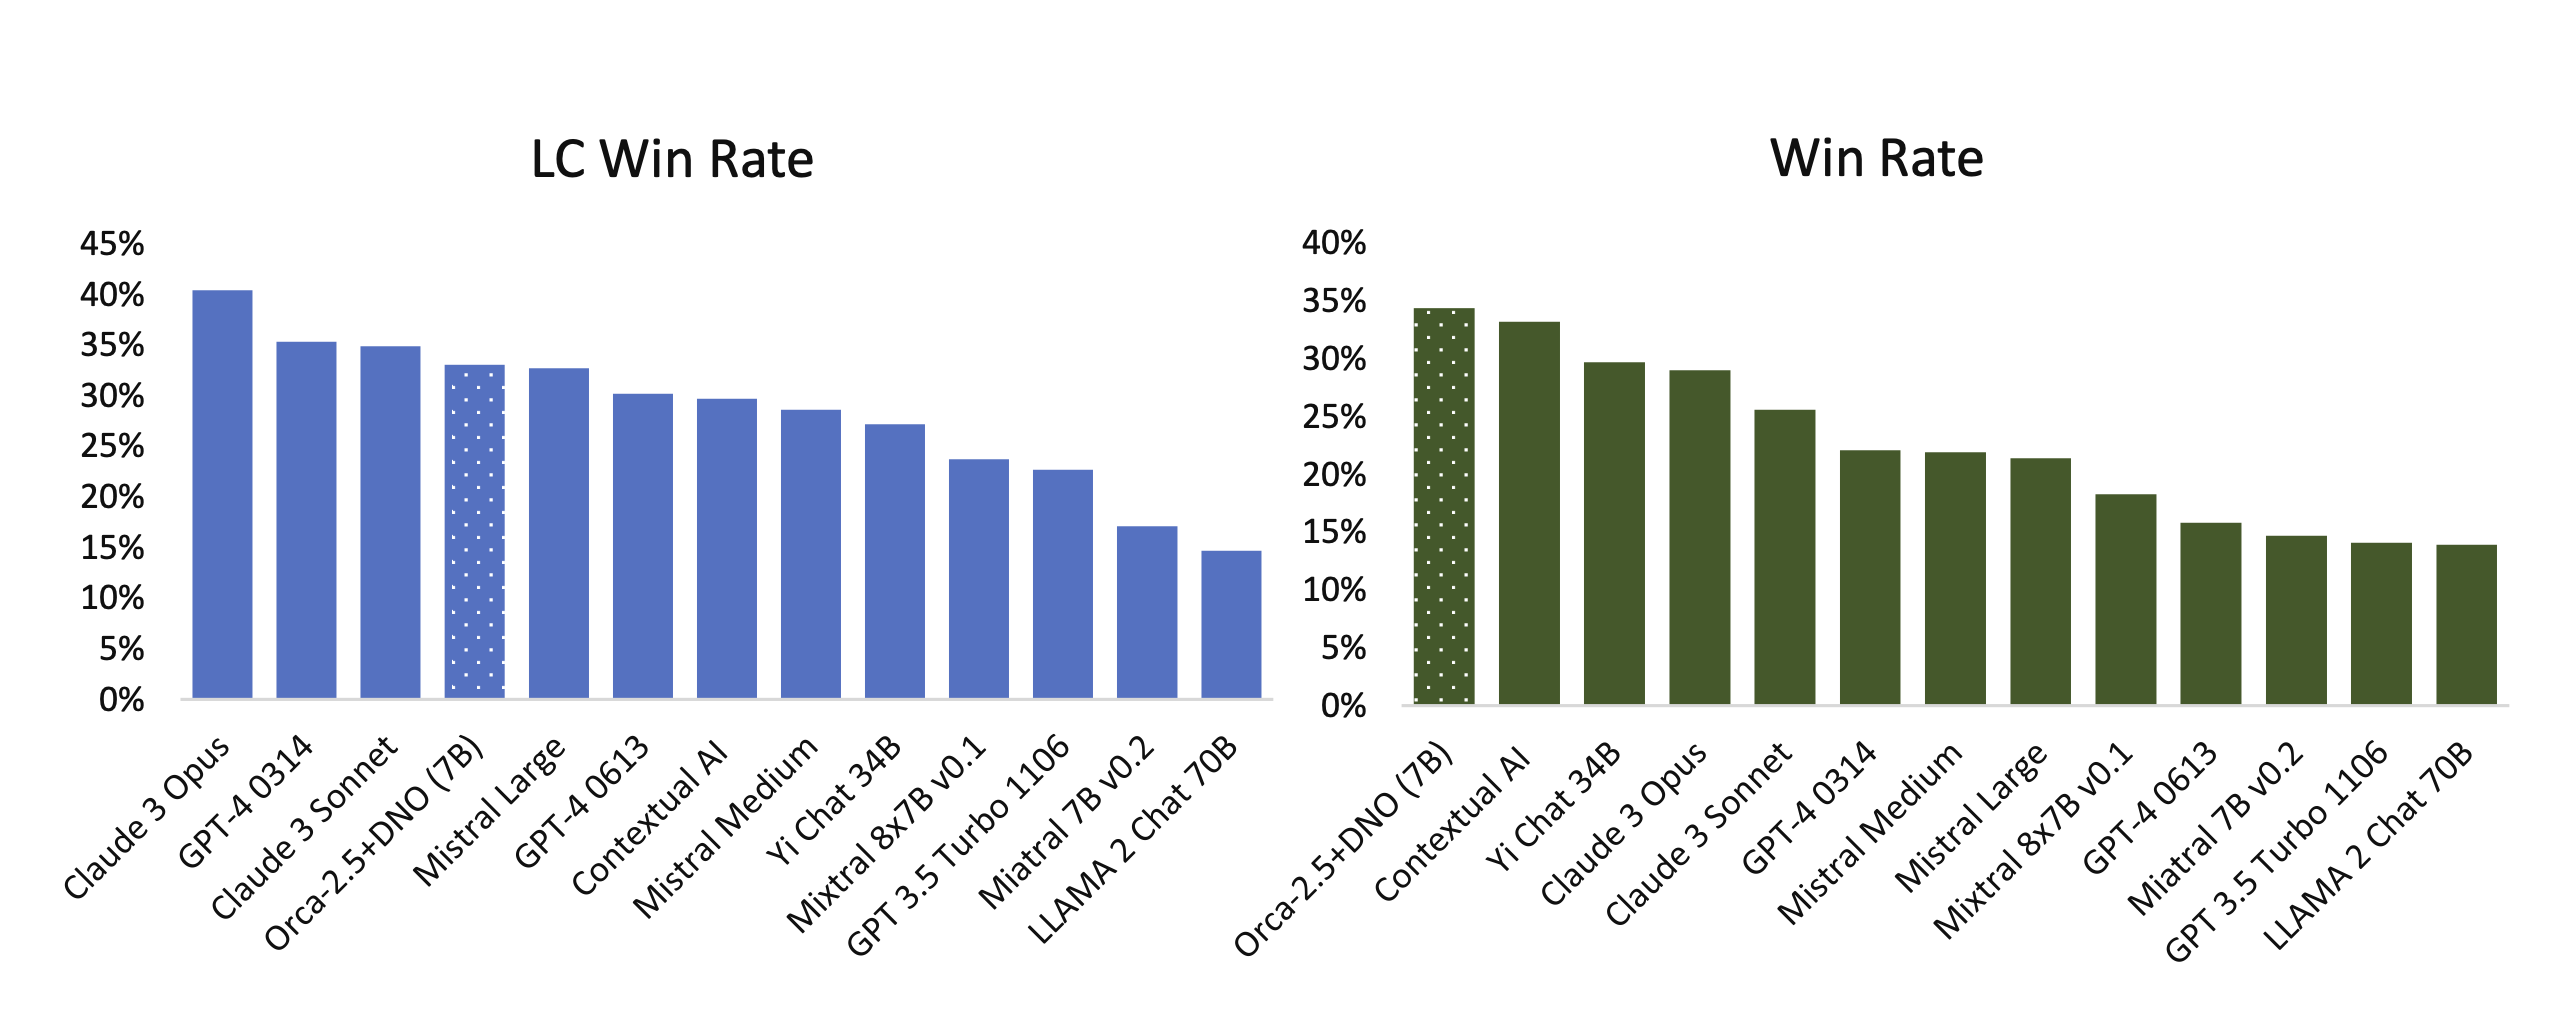
即便是开创性的Self Rewarding Language Models [2],也曾在Llama 2 70B上报告了不现实的高分。 70B模型确实比7B更接近GPT-4(Llama 3已证明这一点),但我们必须区分模型实际能力与RLHF论文中的夸大宣传。 类似的“方法热潮”反复出现,既带来了有价值的见解,也让RLHF变得更难理解。
“怪异RLHF”模型的一个典型症状就是长度偏差(length bias)。 这一现象如此普遍,以至于AlpacaEval、WildBench等评测系统都引入了线性长度修正机制。 这样既修正了“话痨刷榜”的激励,也让短小实用的模型有机会胜出。
即便如此,仅仅为“话痨”而对齐模型,依然在学术圈有一定争议。 Qwen模型的公开说明就曾多次强调“话痨与性能的权衡” [3]:
我们用大量数据预训练模型,并用有监督微调和直接偏好优化后训练。但DPO虽然提升了人工偏好评测,却让基准评测分数下降。
Starling Beta [4] 是一个权衡得当的例子。 它是在OpenChat [5](由另一团队训练)基础上微调的,采用k-wise奖励模型训练和PPO优化,ChatBotArena排名提升了10位。 模型平均回复长度变长,但这种变长确实让人工评测更满意。
“话痨”现象的成因
一个自然的问题是:为什么RLHF会让模型回复变长? 根本原因在于,像ChatBotArena这样的评测显示,普通用户更喜欢完整、详细的回答,而非简短答复。 虽然这并不代表所有用户的偏好,但模型训练的目标是拟合大多数标注者的选择。
如今主流对齐数据集多为合成偏好数据,即用GPT-4等模型对其他模型输出判优劣。 而GPT-4本身在输出风格和长度上有偏好,因此数据集中“被选中”文本大多来自OpenAI模型或与其风格相近。 当然,数据中也有不少Alpaca、Vicuna等开源模型的输出,这些模型风格差异很大。
一旦我们拥有了“选中模型大多类似ChatGPT”的偏好数据集,对齐方法就会简单地提升这些序列的概率。 虽然数学上涉及批量处理大量选中-被拒对,但本质上模型是在token序列上做credit assignment。 对齐“话痨”本质上是让GPT-4风格的长回复更常出现,弱模型风格的短回复概率降低。 反复优化后,模型生成越来越长、越来越受欢迎的输出。
熟悉RLHF的读者可能会问,优化中的KL约束难道不该阻止这种现象吗? KL约束确实是原始模型分布与新模型分布之间的距离项,能提升优化的鲁棒性,防止过度优化,但好坏模型的界限因此变得微妙。 这也是为何“vibes-based”评测(体验型评测)盛行。 实际上,模型参数足够多时,有限评测集上较小的平均 KL 也可能掩盖特定问题或罕见回答上的大幅行为变化。参数量并不改变 KL 的数学定义;关键在于测量分布与实际使用分布是否一致。