推理训练与推理时扩展
在2016年NeurIPS大会上,Yann LeCun首次提出了著名的“蛋糕比喻”来说明现代机器学习系统中学习发生的位置:
如果智能是一块蛋糕,那么蛋糕的主体是无监督学习,蛋糕上的糖霜是有监督学习,而蛋糕上的樱桃则是强化学习(RL)。
如今,随着现代大语言模型和后训练体系的演进,这个比喻已经基本完善: - 用海量互联网数据做自监督学习构成了“蛋糕的主体”(尤其是从FLOPs消耗来看), - 后训练的起点——指令监督微调(SFT)则是糖霜,让模型适应更窄的分布(结合RLHF精选样本), - 而“纯”强化学习(RL)则是蛋糕上的那颗樱桃。
二元奖励每次只提供有限的反馈信息,但这不意味着 RL 只需少量训练样本;训练可能需要大量回答采样与奖励评估。 这种推理训练方式随着推理模型(reasoning models)的出现而兴起,这类模型结合了本书介绍的后训练技术,并在可验证领域上用RL训练,显著提升了推理、编程、数学等能力。
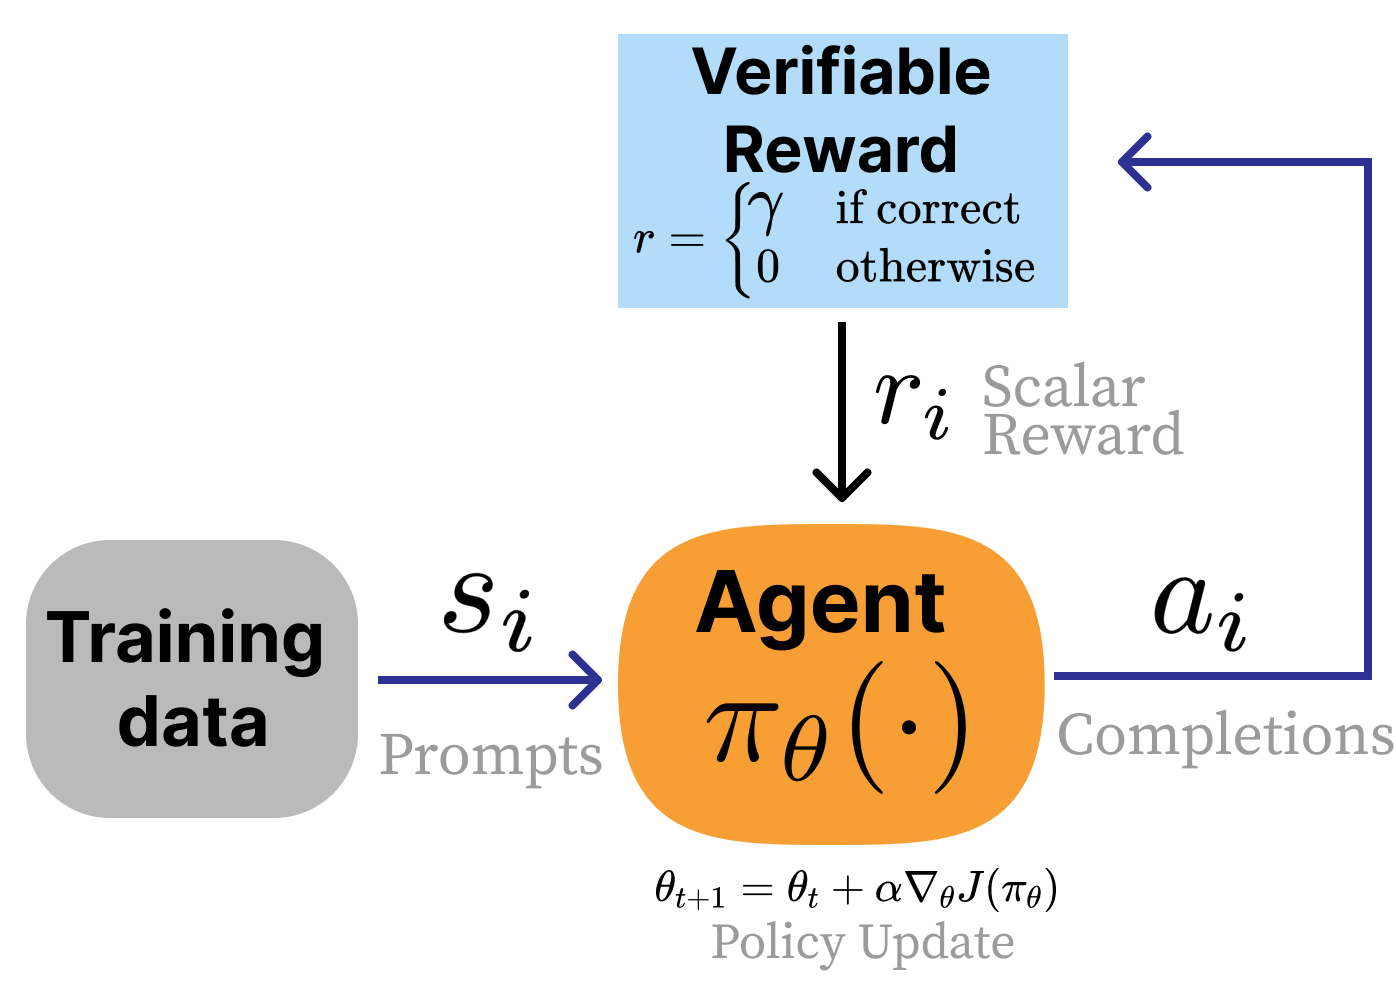
这些模型的训练方式——可验证奖励的强化学习(Reinforcement Learning with Verifiable Rewards, RLVR)[1],与RLHF非常类似,但奖励模型可选,可以直接用一个评分函数:答案正确则奖励为正,否则为0。
OpenAI o1 的公开介绍强调了强化学习对推理的作用 [2];DeepSeek-R1 技术报告则明确介绍了基于规则的奖励设计 [3]。二者公开的训练细节不同,不能据此假定它们使用完全相同的 RLVR 流程。 很快,整个AI行业都将这种训练流程和模型风格作为优先事项。 这里的核心变化,与其说是RL训练方式的全新突破,不如说是训练各阶段分配和行为优先级的重塑。 推理模型的出现,标志着RL训练规模化的时代到来。
关于这些模型的行为类型,可以看下面这个例子:DeepSeek V3 0325和其推理模型DeepSeek R1,面对“Write me a short poem about a goldfish”这个请求的表现。 DeepSeek V3的回答非常直接:
Goldfish Dreams
In a bowl of glass so clear and round, A tiny goldfish swims without a sound. With scales that gleam like sunlight’s kiss, He drifts along in watery bliss.
A flick of fin, a flash so bright, Chasing bubbles in the light. Does he dream of oceans wide? Or is his little world enough—his pride?
而DeepSeek R1则完全不同。 它会先生成大量“思考”token,规划答案后再正式回复:
<thinking>好的,用户想要一首关于金鱼的短诗。让我先头脑风暴一些金鱼相关的意象。金鱼通常在鱼缸里,对吧?那可以从环境描写入手,比如“镀金的鱼缸”或“水晶球”。接下来,思考金鱼的动作。它们游动很平滑,可以用“滑翔”“盘旋”等词,鳍可以形容为“丝绸般”突出精致。
再考虑金鱼周围的环境。阳光穿透水面会有闪烁的效果,可以用“阳光舞动”“涟漪旋转”来描写。加点小城堡或鹅卵石也很有趣。
主题方面?也许可以突出金鱼小世界与自由感的对比,把鱼缸写成宇宙,虽小却完整。结尾可以带点神秘或静默的观察感。需要保持简洁,也许四节押韵。检查一下节奏和流畅度,避免陈词滥调但要易懂。好了,开始拼接吧。
</thinking>Gilded Dreams in Liquid Glass
A gilded bowl, a crystal globe, Where tiny tides in silence flow— A flash of orange, a whispered robe, You dart through sunlit indigo.
Your world is small, yet boundless too— Each pebble, castle, weed unfurled. The surface bends the sky to blue, And ripples spin your liquid world.
You glide through myths we’ll never know, A silent monarch, veiled in mist. Do dreams drift where the bubbles go? Or memories in amethyst?
We watch you trace your endless sphere— A universe within a tear.
<thinking>标签内的内容就是模型的推理过程。
对于更复杂的问题,这个推理阶段可以输出上千token才给出答案。
更大的上下文与生成预算可容纳更长的推理过程,但长输出本身不保证正确性,也不是所有推理任务的必要条件。
这种训练方式的核心直觉是:对于一个模型,反复执行如下循环:
- 对多个问题采样多个答案,
- 验证答案并计算奖励,再根据相对于基线的优势更新策略;错误答案也可能通过负优势参与更新,
- 重复多次,反复访问同一批数据。
令人惊讶的是,这种极其简单的做法(前提是数据分布和训练基础设施稳定)能让模型通过反复练习同一问题真正学会推理。 更令人惊讶的是,这些训练题上的提升还能泛化到模型从未见过的新问题和新领域!
这种方法本质上让模型在行为空间中做轻微搜索,RL算法则提升与正确答案相关的行为概率。
为什么RL现在能“起飞”?
尽管曾有无数观点认为“RL还没用” [4],或论文指出RL可复现性差 [5],但该领域最终还是找到了高影响力的应用场景。 大语言模型上的RL训练热潮,标志着该领域一些根本性问题取得了进展,包括:
- RL的稳定性问题可以解决:RL被广泛采用的最大障碍一直是稳定性。表现在两个方面:一是学习过程本身容易不稳定、失败;二是训练比标准语言模型更容易出现loss爆炸、崩溃等问题。如今,越来越多的模型采用这种RL训练方式,学术界也大量跟进。RL的技术门槛已降到历史新低。
- 开源工具已“齐备”:用于RLVR及相关技术训练语言模型的工具已经非常丰富。比如TRL [6]、Open Instruct [1]、veRL [7]、OpenRLHF [8]等,这些工具很多都融合了RLHF和后训练的优化经验。工具的易用性极大促进了研究扩展,预计本章内容很快就会过时。
预训练模型已有的推理能力与采样到有效答案的概率,会影响后续 RL 的效果;不能将 2024 年作为这种方法可行与否的硬性分界。
RL训练 vs. 推理时扩展
用强化学习训练推理行为与可验证领域表现,与“推理时扩展”(Inference-time Scaling)密切相关。 推理时扩展(也叫测试时扩展)是一类方法:在推理时投入更多算力,以提升下游任务表现。 早在DeepSeek R1和OpenAI o1发布前,这类方法就已被研究,如价值引导采样 [9]、重复随机采样和答案抽取 [10]等。 此外,推理时扩展还可用于提升更多AI训练方法,如奖励模型深度思考选项 [11] [12]。
RL训练是推理时扩展定律的“捷径”,但长期来看,我们会有更多方法来实现推理时表现与资源的最优权衡。 大量RL训练会让模型每次回复生成更多token,并且这种行为与下游性能高度相关。 这与早期RLHF系统中的长度偏差 [13](即人类偏好训练副作用是回复变长但提升有限)形成鲜明对比。
RL训练后的模型,下游还有许多方法可进一步提升推理和推理时算力利用。 这些内容变化极快,超出本书讨论范畴,包括:用指令微调将大模型的推理行为蒸馏到小模型 [14],组合多次推理调用 [15] 等。 关键是,下游表现与生成token数增加高度相关——否则只是浪费能量。
强化微调的未来(超越推理)
在许多领域,RLVR和强化微调的新范式更贴合开发者的实际目标——关注性能而非仅仅是行为。 标准微调API通常采用参数高效微调(如LoRA)+指令有监督微调。开发者提供prompt和补全,模型通过参数更新学会复现这些补全,从而让数据特征在生成中更突出。
强化微调则更关注“答对题”。给定问题和标准答案,RFT帮助模型学会输出正确答案。 一些强化微调流程会反复使用同一组问题,并不断重新采样回答。更新步数、采样轮次与遍历固定数据的 epoch 不是同一概念;训练预算应由验证集表现、泛化与过拟合风险决定,而不是套用固定的数百或数千轮。 这可以看作是把基础模型中偶尔出现的正向行为,通过RFT“强化”为稳定可靠的能力。
RL训练在语言模型中的应用空间仍在不断扩大:o1和R1等模型带来的最大科学启示是,我们有了更多方式将大语言模型训练为具备潜在价值的行为体。研究者和工程师拥有的选择越多,AI的未来就越值得乐观。