直接对齐算法
直接对齐算法(Direct Alignment Algorithms, DAAs)允许我们在无需训练奖励模型或使用强化学习优化器的情况下,直接优化RLHF目标。 其中最具代表性、并掀起学术界大规模关注的,是直接偏好优化(Direct Preference Optimization, DPO)[1]。 DPO 将 KL 正则化奖励最大化问题中的最优策略关系代入偏好模型,得到可直接训练策略的分类损失。实际训练最小化偏好损失,并不保证有限数据和有限优化步骤下达到原目标的全局最优。 自2023年5月发布以来,经过社区对数据和超参数(尤其是意外地低学习率)的探索,DPO及其变体被广泛应用于主流模型,如Zephyr-\(\beta\)(2023年10月)[2]、Llama 3 Instruct [3]、Tülu 2 [4]、Tülu 3 [5]、Nemotron 4 340B [6]等。 严格来说,Sequence Likelihood Calibration(SLiC-HF)[7]更早提出,但因有效性和运气等原因未被广泛采用。
DPO和DAAs最重要的意义,是极大降低了语言模型后训练的技术门槛。
直接偏好优化(Direct Preference Optimization, DPO)
下面我们将直观解释DPO的原理,并推导其核心公式。
DPO的原理
DPO表面上是直接优化策略以求解RLHF目标。 其损失函数本质上是log概率的成对关系。 Bradley-Terry奖励模型推导出的损失函数如下:
\[ \begin{aligned} h_\theta(x,y_c,y_r)&=\log\frac{\pi_\theta(y_c|x)}{\pi_{\mathrm{ref}}(y_c|x)} -\log\frac{\pi_\theta(y_r|x)}{\pi_{\mathrm{ref}}(y_r|x)},\\ \mathcal{L}_{\mathrm{DPO}}&=-\mathbb{E}_{(x,y_c,y_r)\sim\mathcal{D}} \big[\log\sigma(\beta h_\theta(x,y_c,y_r))\big]. \end{aligned} \qquad{(1)}\]
这里用到DPO的隐式奖励:
\[r(x, y) = \beta \log \frac{\pi_\theta(y \mid x)}{\pi_{\text{ref}}(y \mid x)}\qquad{(2)}\]
这个奖励来自Bradley-Terry模型下的最优策略推导(见式 8)。 这是用策略与参考策略的 log 概率比参数化的隐式奖励,不是一个概率。完整奖励还可包含仅依赖 prompt 的加法项 \(\beta\log Z(x)\);该项在成对奖励差中抵消。
观察式 1中的损失,优化目标是让选中回复的log比率大于被拒回复(归一化参考模型)。 实际中,这就是对模型在数据中token序列的log概率求和。 因此,DPO实质上是在拉大选中与被拒回复概率的差距。
有了式 2中的奖励,我们可以写出损失的梯度,进一步理解机制:
\[ \begin{aligned} \nabla_\theta\mathcal{L}_{\mathrm{DPO}} =-\beta\mathbb{E}_{\mathcal{D}}\Big[&\sigma(r_\theta(x,y_r)-r_\theta(x,y_c))\\ &\cdot\big(\nabla_\theta\log\pi_\theta(y_c|x)-\nabla_\theta\log\pi_\theta(y_r|x)\big)\Big]. \end{aligned} \qquad{(3)}\]
直观理解如下:
- \(\sigma(\cdot)\)中的第一项,为参数更新赋予0到1的权重,当奖励估计错误时(被拒样本更优),权重更大。
- 内部括号\([\cdot]\)项提升选中回复\(y_c\)的概率,降低被拒回复\(y_r\)的概率。
- \(\beta\)控制优化中排序与KL距离的平衡。
核心直觉是,DPO“隐式拟合了一个奖励模型,其对应最优策略可解析写出”(归功于梯度上升和ML工具)。 DPO 确实直接更新策略参数;同一个语言模型同时给出了隐式奖励的参数化,而不是先独立训练奖励模型再用 RL 优化策略。
在 Bradley-Terry 偏好假设、足够的模型表达能力与充分优化等条件下,可以通过这一参数化联系偏好拟合与 KL 正则化目标的最优策略。经验训练效果仍受数据覆盖、模型容量和优化过程限制。 与策略梯度类RL方法的区别在于,DPO的生成不是在线的,而是离线的,因此\(\beta\)更易调节,但最优值依赖于具体模型与数据。
对每批偏好数据,DPO 直接计算离线偏好损失并更新策略,省去了训练循环中的在线 rollout 和显式价值估计。
DPO公式推导
DPO推导分两步: 1. 推导RLHF目标的最优策略形式; 2. 用Bradley-Terry模型推导如何从偏好数据获得该解。
1. RLHF最优解推导
对固定奖励函数 \(r\)、\(\beta>0\) 和参考策略,在其支持集上考虑:
\[ \begin{aligned} \pi^* &= \arg\max_\pi J(\pi),\\ J(\pi) &= \mathbb{E}_{x\sim\mathcal{D}}\left[ \mathbb{E}_{y\sim\pi(\cdot|x)}r(x,y) -\beta D_{\mathrm{KL}}(\pi(\cdot|x)\|\pi_{\mathrm{ref}}(\cdot|x))\right]. \end{aligned} \qquad{(4)}\]
展开 KL,并将目标乘以负数 \(-1/\beta\),最大化转为最小化。这里相等的是最优策略集合,不是目标函数的数值:
\[ \pi^*=\arg\min_\pi\mathbb{E}_{x\sim\mathcal{D},\,y\sim\pi(\cdot|x)} \left[\log\frac{\pi(y|x)}{\pi_{\mathrm{ref}}(y|x)}-\frac{r(x,y)}{\beta}\right]. \qquad{(5)}\]
定义有限的配分函数(partition function):
\[Z(x)=\sum_y\pi_{\mathrm{ref}}(y|x)\exp(r(x,y)/\beta).\qquad{(6)}\]
令 \(q(y|x)=\pi_{\mathrm{ref}}(y|x)\exp(r(x,y)/\beta)/Z(x)\),则:
\[ \pi^*=\arg\min_\pi\mathbb{E}_{x\sim\mathcal{D}} \left[D_{\mathrm{KL}}(\pi(\cdot|x)\|q(\cdot|x))-\log Z(x)\right]. \qquad{(7)}\]
\(Z(x)\) 与待优化策略无关。由 KL 非负性,当策略等于 \(q\) 时取得最小值,因此:
\[\pi^*(y|x)=\frac{1}{Z(x)}\pi_{\mathrm{ref}}(y|x)\exp(r(x,y)/\beta).\qquad{(8)}\]
2. Bradley-Terry模型下的DPO目标
回顾第7章奖励建模与第6章偏好数据,Bradley-Terry模型为:
\[p^*(y_1 \succ y_2 \mid x) = \frac{\exp\left(r^*(x,y_1)\right)}{\exp\left(r^*(x,y_1)\right) + \exp\left(r^*(x, y_2)\right)} \qquad{(9)}\]
对式 8取对数并代入,得DPO奖励:
\[r^*(x, y) = \beta \log \frac{\pi^*(y \mid x)}{\pi_{\text{ref}}(y \mid x)} + \beta \log Z(x)\qquad{(10)}\]
代入Bradley-Terry公式,化简后得:
\[p^*(y_1 \succ y_2 \mid x) = \sigma\left(\beta \log \frac{\pi^*(y_1 \mid x)}{\pi_{\text{ref}}(y_1 \mid x)} - \beta \log \frac{\pi^*(y_2 \mid x)}{\pi_{\text{ref}}(y_2 \mid x)}\right) \qquad{(11)}\]
这正是DPO的损失函数(见式 1)。
3. Bradley-Terry DPO梯度推导
DPO梯度如式 3所示,推导如下:
\[ \nabla_\theta\mathcal{L}_{\mathrm{DPO}}=-\mathbb{E}_{\mathcal{D}}\left[\nabla_\theta\log\sigma(\beta h_\theta)\right]. \qquad{(12)}\]
利用sigmoid和log的求导性质,可化为:
\[ \begin{aligned} \nabla_\theta\mathcal{L}_{\mathrm{DPO}} &=-\beta\mathbb{E}_{\mathcal{D}}\left[\sigma(-\beta h_\theta)\nabla_\theta h_\theta\right],\\ \nabla_\theta h_\theta &=\nabla_\theta\log\pi_\theta(y_c|x)-\nabla_\theta\log\pi_\theta(y_r|x). \end{aligned} \qquad{(13)}\]
数值问题、局限与变体
DPO算法已出现多种变体,旨在解决其局限。 例如,DPO在无奖励模型评分的情况下,对每对偏好数据赋予同等权重,忽略了更丰富的标签信息。 为此,相关算法尝试重新平衡优化目标:
- REBEL:将奖励模型分数作为选中与被拒回复之间的margin,提升RLHF问题的求解准确性 [8]。
- 保守 DPO(cDPO)与恒等偏好优化(IPO):cDPO 用标签平滑处理潜在偏好噪声 [1];IPO 在其一般偏好优化框架中采用恒等映射,并使用平方损失约束相对 log 概率比,以缓解对确定性偏好的过拟合 [9]。
- 带偏移的DPO(ODPO):要求选中与被拒回复的likelihood差异大于某个阈值,不再一视同仁 [10]。
有些变体通过调整损失函数或内存优化提升学习信号或效率:
- ORPO(Odds Ratio Policy Optimization):将选中回复的负对数似然与基于 odds ratio 的偏好损失结合,抑制相对不受偏好的回答,无需参考模型 [11]。
- SimPO(Simple Preference Optimization):以长度归一化的回答 log 概率作为隐式奖励,并引入目标奖励间隔;无需参考模型 [12]。
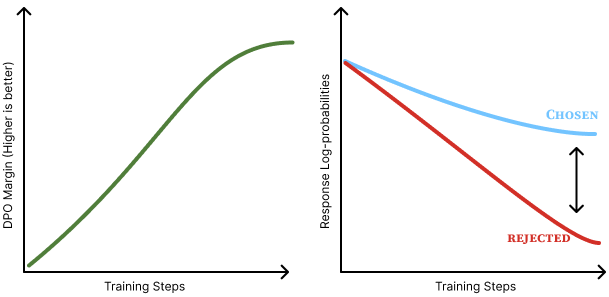
DPO的一个突出问题是:优化目标仅仅是拉大选中与被拒回复概率的间隔。 数值上,可能出现两者概率都下降、被拒回复下降更多的情况(见图 2)。 这对泛化的影响尚不明确,有研究认为这会提升未被覆盖行为的概率 [13] [14]。 如Cal-DPO [15]、AlphaPO [16]等方法通过调整优化过程或奖励形状缓解这种偏好位移。 实际影响尚不明朗,但这可能是在线RL方法优于DPO的原因之一。
另一个DPO类方法性能上限低于在线RLHF的主要原因,是其训练信号来自其他模型的补全。 在线变体如Online DPO [17],或结合奖励模型重标记的新生成数据的Discriminator-Guided DPO(D2PO) [18],通过实时生成新补全并引入偏好信号,缓解了这一问题。
还有许多DAA变体,如Direct Nash Optimization(DNO)[19]、Binary Classifier Optimization(BCO)[20]等,但目前算法选择远不如初始模型和数据重要 [5] [21] [22]。
实现注意事项
DAA如DPO的实现方式与策略梯度优化器有很大不同。 DPO损失函数的典型实现如下 [1]:
import torch.nn.functional as F

# logps 是仅对回答 token 求和的序列 log 概率;参考模型保持冻结
pi_logratios = policy_chosen_logps - policy_rejected_logps
ref_logratios = reference_chosen_logps - reference_rejected_logps

logits = pi_logratios - ref_logratios  # 即 h_{\pi_\theta}^{y_w,y_l}

losses = -F.logsigmoid(beta * logits)

chosen_rewards = beta * (policy_chosen_logps - reference_chosen_logps).detach()
rejected_rewards = beta * (policy_rejected_logps - reference_rejected_logps).detach()
这可以直接用于标准语言模型训练流程(只需加一个参考模型)。
这种方式更简单,也提升了开发体验,但有一些新的注意点:
- \(\beta\) 不是固定的 KL 距离:\(\beta\) 来自正则化系数,并在 DPO 损失中缩放 log 概率比。实际 KL 还受训练数据、学习率、训练步数与模型影响,不能由 \(\beta\) 直接指定,也不保证每一步都趋近全局最优。应通过评测与实际分布漂移监测选择超参数。
- 缓存log概率:简单实现中,policy和reference模型同时前向推理,方便损失计算,但会使显存消耗翻倍。可先离线计算参考模型log概率,训练时直接查表,显著降低显存需求。
DAA与RL:在线与离线数据
本质问题是:我们是否需要强化学习的内部机制(如值函数、策略梯度等)来实现RLHF对齐? 当然,二者各有成熟体系,关键在于理解两者的本质差异和性能表现。
多项研究发现,基于策略梯度和RL的方法在性能上优于DPO及其变体。 这些研究通过控制数据、算法对比训练模型 [23] [24],或研究RL优化循环中on-policy数据的作用 [25],都显示DPO略逊一筹。
尽管如此,DAA因其简单性在主流模型中广泛应用。 DAA为训练数据和配置的快速迭代提供了极大便利,而数据往往比算法本身更重要,因此DPO在实际中依然很有价值。
随着以RL为主的推理模型兴起,未来会有更多投资回归RL偏好微调,这将提升RL基础设施的健壮性,并进一步拉开DAA与RLHF在线优化的性能差距。