拒绝采样
拒绝采样(Rejection Sampling, RS)是一种流行且简单的偏好微调基线方法。 其基本思想是:先生成一批新的候选指令补全,通过已训练好的奖励模型进行筛选,然后只用得分最高的补全对原始模型进行微调。
“拒绝采样”一词源自计算统计学 [1],原意是:当目标分布复杂且无法直接采样时,先从易采样的分布中采样,再根据目标分布与提议分布的密度比及包络常数确定接受概率。本章常说的奖励筛选或 Best-of-N 微调借用了这一名称,并不自动具备统计学拒绝采样的精确分布保证。 在语言模型场景下,目标分布是高质量的指令回答,筛选器是奖励模型,采样分布则是当前模型本身。
许多重要的RLHF与偏好微调论文都将拒绝采样作为基线,但目前尚无标准实现和详细文档。
如WebGPT [2]、Anthropic的Helpful and Harmless agent [3]、OpenAI的过程奖励模型论文 [4]、Llama 2 Chat模型 [5]等都采用了这一基线。
训练流程
下图(图 1)展示了拒绝采样的整体流程:
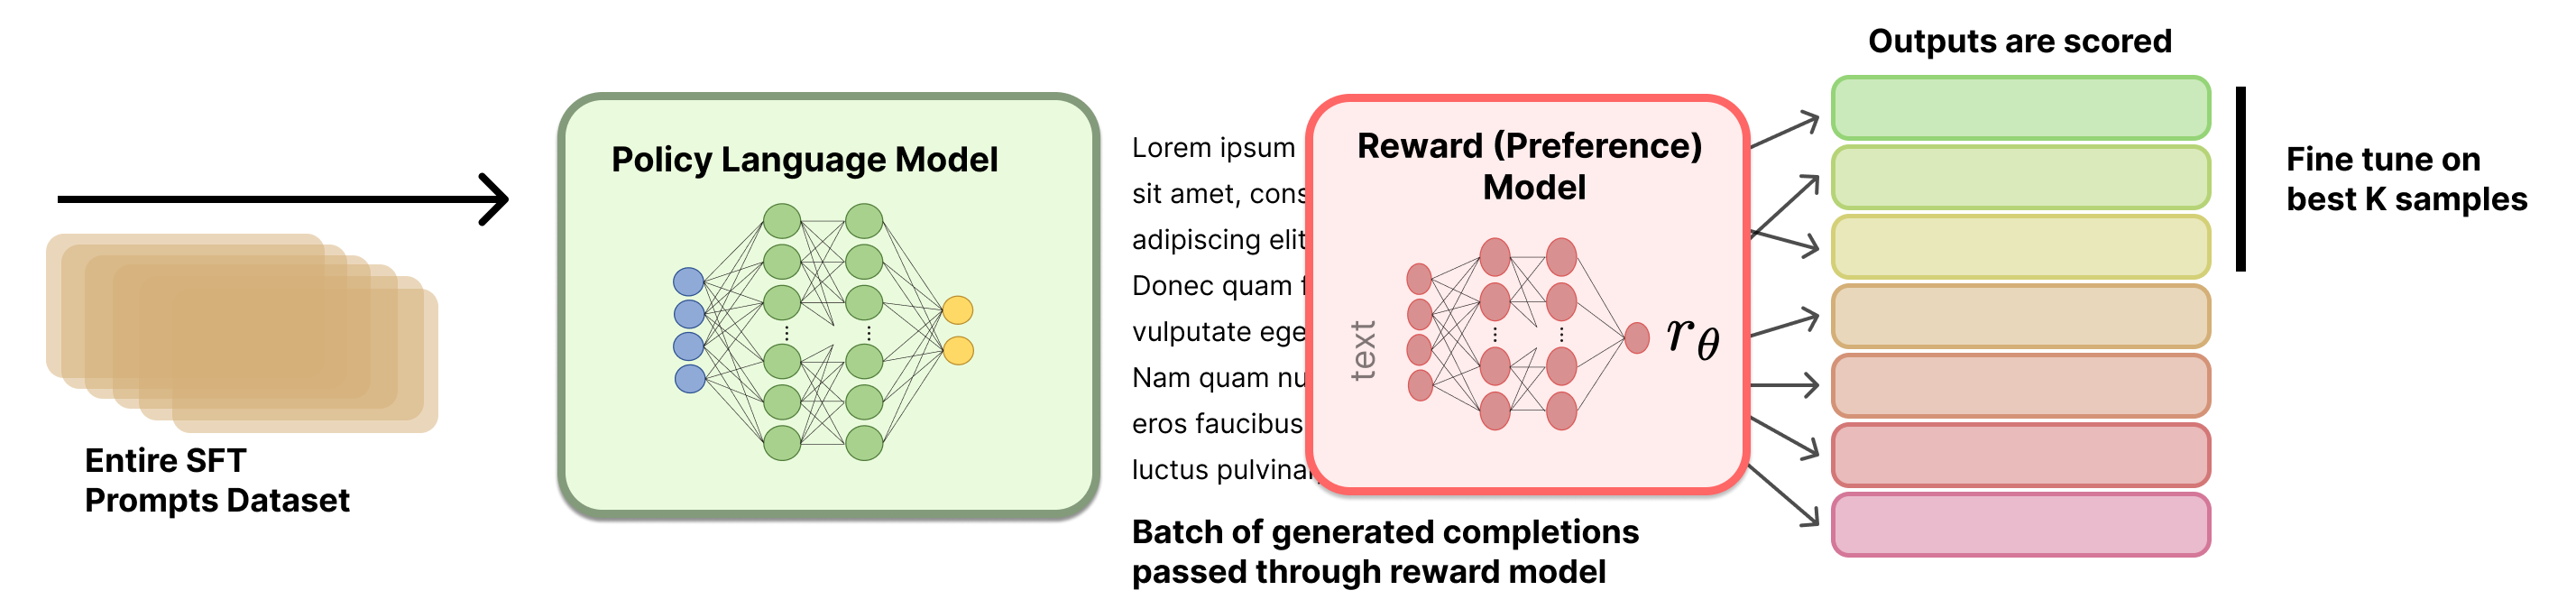
生成补全
假设我们有\(M\)个prompt,记为向量:
\[X = [x_1, x_2, ..., x_M]\]
这些prompt可以来自多个来源,最常见的是指令微调数据集。
对于每个prompt \(x_i\),生成\(N\)个补全,可表示为矩阵:
\[Y = \begin{bmatrix} y_{1,1} & y_{1,2} & \cdots & y_{1,N} \\ y_{2,1} & y_{2,2} & \cdots & y_{2,N} \\ \vdots & \vdots & \ddots & \vdots \\ y_{M,1} & y_{M,2} & \cdots & y_{M,N} \end{bmatrix}\]
其中\(y_{i,j}\)是第\(i\)个prompt的第\(j\)个补全。 将所有prompt-补全对输入奖励模型,得到奖励矩阵\(R\):
\[R = \begin{bmatrix} r_{1,1} & r_{1,2} & \cdots & r_{1,N} \\ r_{2,1} & r_{2,2} & \cdots & r_{2,N} \\ \vdots & \vdots & \ddots & \vdots \\ r_{M,1} & r_{M,2} & \cdots & r_{M,N} \end{bmatrix}\]
每个奖励\(r_{i,j}\)由奖励模型\(\mathcal{R}\)对补全\(y_{i,j}\)和对应prompt \(x_i\)评分:
\[r_{i,j} = \mathcal{R}(y_{i,j}|x_i)\]
选择Top-N补全
筛选用于训练的最佳补全有多种方式。
形式化地,我们定义一个选择函数\(S\),作用于奖励矩阵\(R\)。
每个prompt选择最优
最直接的选择方式是对每个prompt取最大值:
\[S(R) = [\arg\max_{j} r_{1,j}, \arg\max_{j} r_{2,j}, ..., \arg\max_{j} r_{M,j}]\]
\(S\)返回每行最大值的列索引。用这些索引选出最终补全:
\[Y_{chosen} = [y_{1,S(R)_1}, y_{2,S(R)_2}, ..., y_{M,S(R)_M}]\]
全局Top-K选择
也可从所有 prompt-补全对中选出得分最高的 K 个,但需谨慎:成对偏好训练只约束同一 prompt 内的分数差,不保证不同 prompt 的绝对分数可比较。全局筛选可能改变 prompt 分布。 先将\(R\)展平成一维向量:
\[R_{flat} = [r_{1,1}, r_{1,2}, ..., r_{1,N}, r_{2,1}, r_{2,2}, ..., r_{2,N}, ..., r_{M,1}, r_{M,2}, ..., r_{M,N}]\]
\(R_{flat}\)长度为\(M \times N\)。
定义选择函数\(S_K\),取\(R_{flat}\)中最大的K个索引:
\[S_K(R_{flat}) = \text{argsort}(R_{flat})[-K:]\]
\(\text{argsort}\)返回升序排序的索引,取最后K个即为最大值。
然后将这些索引映射回原始补全矩阵Y,即可获得选中的补全。
选择示例
假设有5个prompt,每个4个补全,奖励矩阵如下:
\[R = \begin{bmatrix} 0.7 & 0.3 & 0.5 & 0.2 \\ 0.4 & 0.8 & 0.6 & 0.5 \\ 0.9 & 0.3 & 0.4 & 0.7 \\ 0.2 & 0.5 & 0.8 & 0.6 \\ 0.5 & 0.4 & 0.3 & 0.6 \end{bmatrix}\]
每prompt选择最优,即每行最大值为:
\[R = \begin{bmatrix} \textbf{0.7} & 0.3 & 0.5 & 0.2 \\ 0.4 & \textbf{0.8} & 0.6 & 0.5 \\ \textbf{0.9} & 0.3 & 0.4 & 0.7 \\ 0.2 & 0.5 & \textbf{0.8} & 0.6 \\ 0.5 & 0.4 & 0.3 & \textbf{0.6} \end{bmatrix}\]
用argmax方法,选出每个prompt的最佳补全:
\[S(R) = [\arg\max_{j} r_{i,j} \text{ for } i \in \{1,\ldots,5\}]\]
\[S(R) = [1, 2, 1, 3, 4]\]
即:
- prompt 1: 补全1(0.7)
- prompt 2: 补全2(0.8)
- prompt 3: 补全1(0.9)
- prompt 4: 补全3(0.8)
- prompt 5: 补全4(0.6)
全局最优,高亮全局前5个补全:
\[R = \begin{bmatrix} \textbf{0.7} & 0.3 & 0.5 & 0.2 \\ 0.4 & \textbf{0.8} & 0.6 & 0.5 \\ \textbf{0.9} & 0.3 & 0.4 & \textbf{0.7} \\ 0.2 & 0.5 & \textbf{0.8} & 0.6 \\ 0.5 & 0.4 & 0.3 & 0.6 \end{bmatrix}\]
展平后:
\[R_{flat} = [0.7, 0.3, 0.5, 0.2, 0.4, 0.8, 0.6, 0.5, 0.9, 0.3, 0.4, 0.7, 0.2, 0.5, 0.8, 0.6, 0.5, 0.4, 0.3, 0.6]\]
取最大 5 个索引(展平索引从 0 开始,按分数升序列出;同分项次序可互换):
\[S_5(R_{flat}) = [0, 11, 5, 14, 8]\]
映射回原矩阵:
- 8 → prompt 3, 补全1(0.9)
- 5 → prompt 2, 补全2(0.8)
- 14 → prompt 4, 补全3(0.8)
- 0 → prompt 1, 补全1(0.7)
- 11 → prompt 3, 补全4(0.7)
代码实现示例
以下为选择方法的代码片段:
import numpy as np

x = np.random.randint(10, size=10)
print(f"{x=}")
sorted_indices = np.argsort(x)
x_sorted = x[sorted_indices]
print(f"{x_sorted=}")

# 恢复原数组的第一种方式
i_rev = np.zeros(10, dtype=int)
i_rev[sorted_indices] = np.arange(10)
np.allclose(x, x_sorted[i_rev])

# 恢复原数组的第二种方式
np.allclose(x, x_sorted[np.argsort(sorted_indices)])
微调
选出补全后,即可对当前模型进行标准的指令微调。 更多细节可参考指令微调章节。
细节说明
拒绝采样的具体实现细节相对较少,但核心超参数直观易懂:
- 采样参数:拒绝采样高度依赖模型生成的补全。常用温度大于0(如0.7~1.0),top-p或top-k等参数也可调整。
- 每个prompt生成补全数:成功案例通常每个prompt生成10~30个甚至更多补全。太少会导致训练偏差或噪声大。
- 指令微调细节:拒绝采样阶段的指令微调细节未有公开标准,可能与初始指令微调略有不同。
- 多模型生成:有些实现会用多个模型生成补全,而非仅用当前待训练模型。最佳实践尚无定论。
- 奖励模型训练:奖励模型的训练质量极大影响最终效果。更多内容参见奖励建模章节。
实用技巧
- 批量做奖励模型推理时,可按补全长度排序,使每批长度接近,减少padding,提高推理效率,代价是实现稍复杂。
相关:Best-of-N采样
Best-of-N(BoN)采样常作为RLHF方法的对比基线。 需注意,BoN不会修改模型本身,仅是一种采样策略。 因此,将BoN与如PPO等在线训练方法对比,在某些场景下依然合理。 例如,可以比较BoN采样与其他策略的KL距离等。
对于单个prompt,BoN采样下两种选择方法等价:
设R为单prompt的N个补全的奖励向量:
\[R = [r_1, r_2, ..., r_N]\qquad{(1)}\]
用argmax方法选出最佳补全:
\[S(R) = \arg\max_{j \in [1,N]} r_j\qquad{(2)}\]
Top-K方法若取Top-1,也等价于上述方法。