偏好数据
偏好数据是偏好微调(Preference Finetuning)和人类反馈强化学习(RLHF)的核心动力。 这些数据为团队提供了行为对齐的信号,以便模型能够学会人们希望它展现的行为,并避免不希望的行为。 在偏好微调领域,已经提出了多种数据收集与利用方法,但只要无法用清晰的奖励函数完全表达人的偏好,标注偏好数据的收集过程就会始终是RLHF及相关技术的核心环节。
为什么需要偏好数据
RLHF之所以需要偏好数据,是因为要直接用一个奖励函数来刻画复杂的人类价值观几乎是不可能的。 收集这些数据用于奖励模型训练,正是RLHF最初的设计理念之一 [1],并且在现代语言模型的发展过程中被广泛采用。 为什么这种数据如此有效?一个核心直觉是:无论对人类还是对辅助数据收集的AI模型来说,判断两个回答哪个更好往往比直接生成一个好答案要容易得多。 本章将重点介绍偏好数据的获取机制,具体最佳实践则依赖于实际要解决的问题。
如何收集偏好数据
充分利用人类数据,往往需要模型的反复迭代训练、不断优化和细化的数据标注说明、借助数据服务公司的协作等多方面的投入。 AI反馈数据也是如此——目前主流AI模型中究竟人类偏好数据和AI偏好数据的比例是多少,外界并不清楚。 无论如何,对于新团队来说,将人类数据纳入模型训练流程是一项不小的挑战。 由于数据的敏感性,只有那些真正能提升模型表现的流程才会被保留下来。
本章将介绍数据格式上的技术决策,以及组织如何高效收集偏好数据的实践经验。
标注界面
收集偏好数据的关键在于与模型交互的界面设计。 下图展示了[2]中的一个标注界面示例:
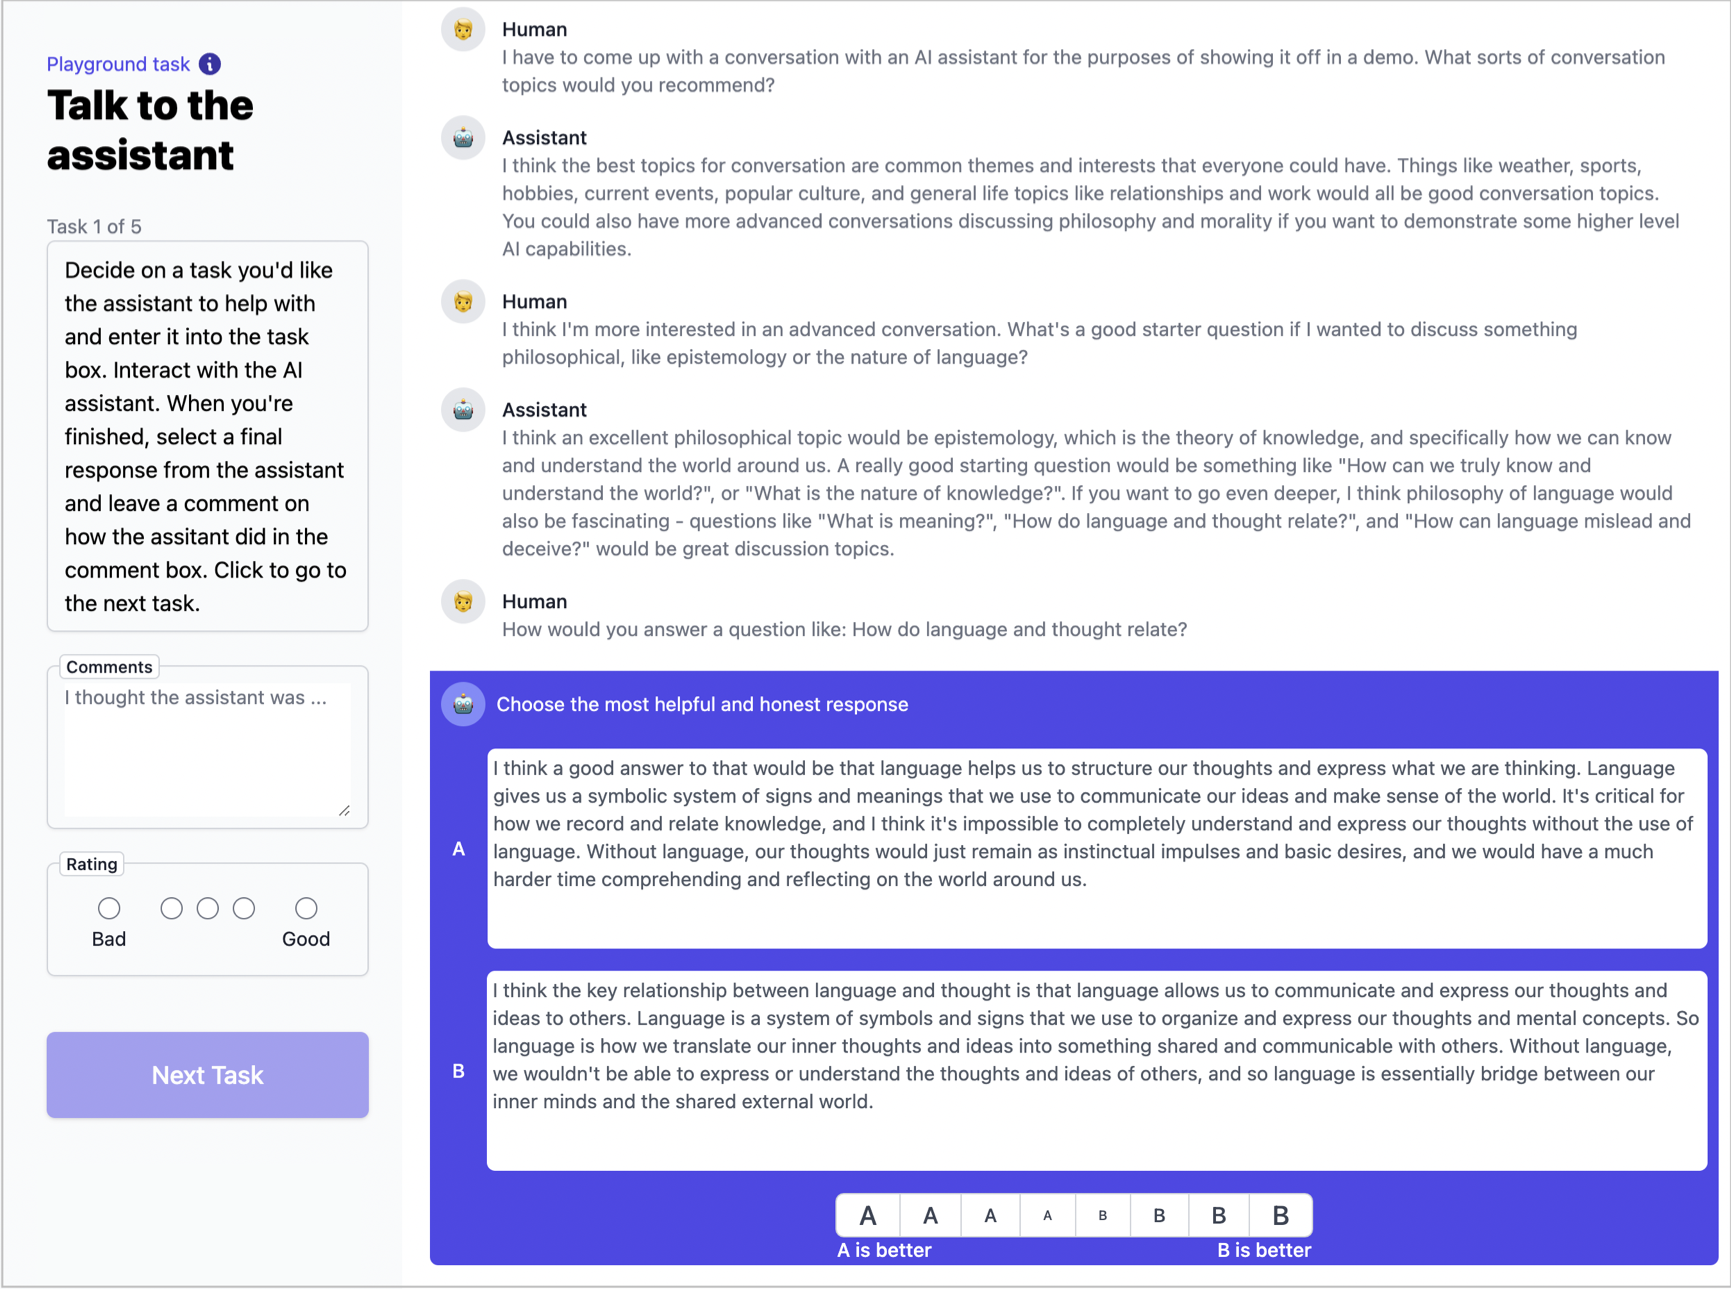
这是一个仅用于训练数据收集的界面。 如今,随着模型的流行,实际应用中往往直接向用户开放数据收集接口用于测试。 下图展示了ChatGPT早期版本的类似交互:
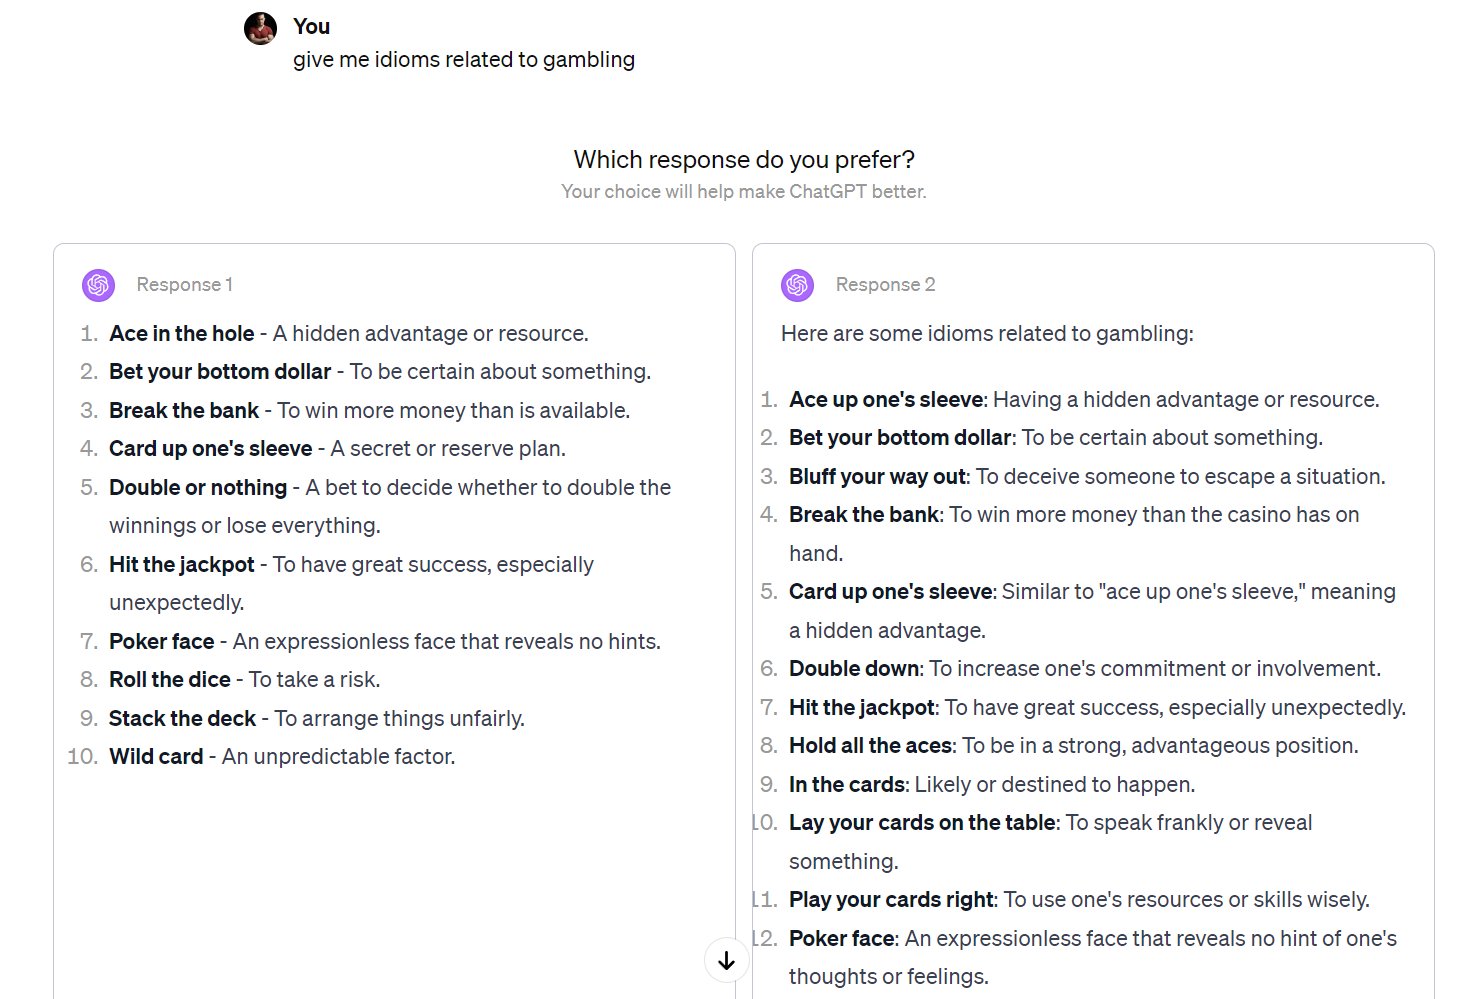
这种界面在业界被广泛用于模型评测等场景。 像ChatBotArena [3] 就是一个流行的公开模型对比平台:
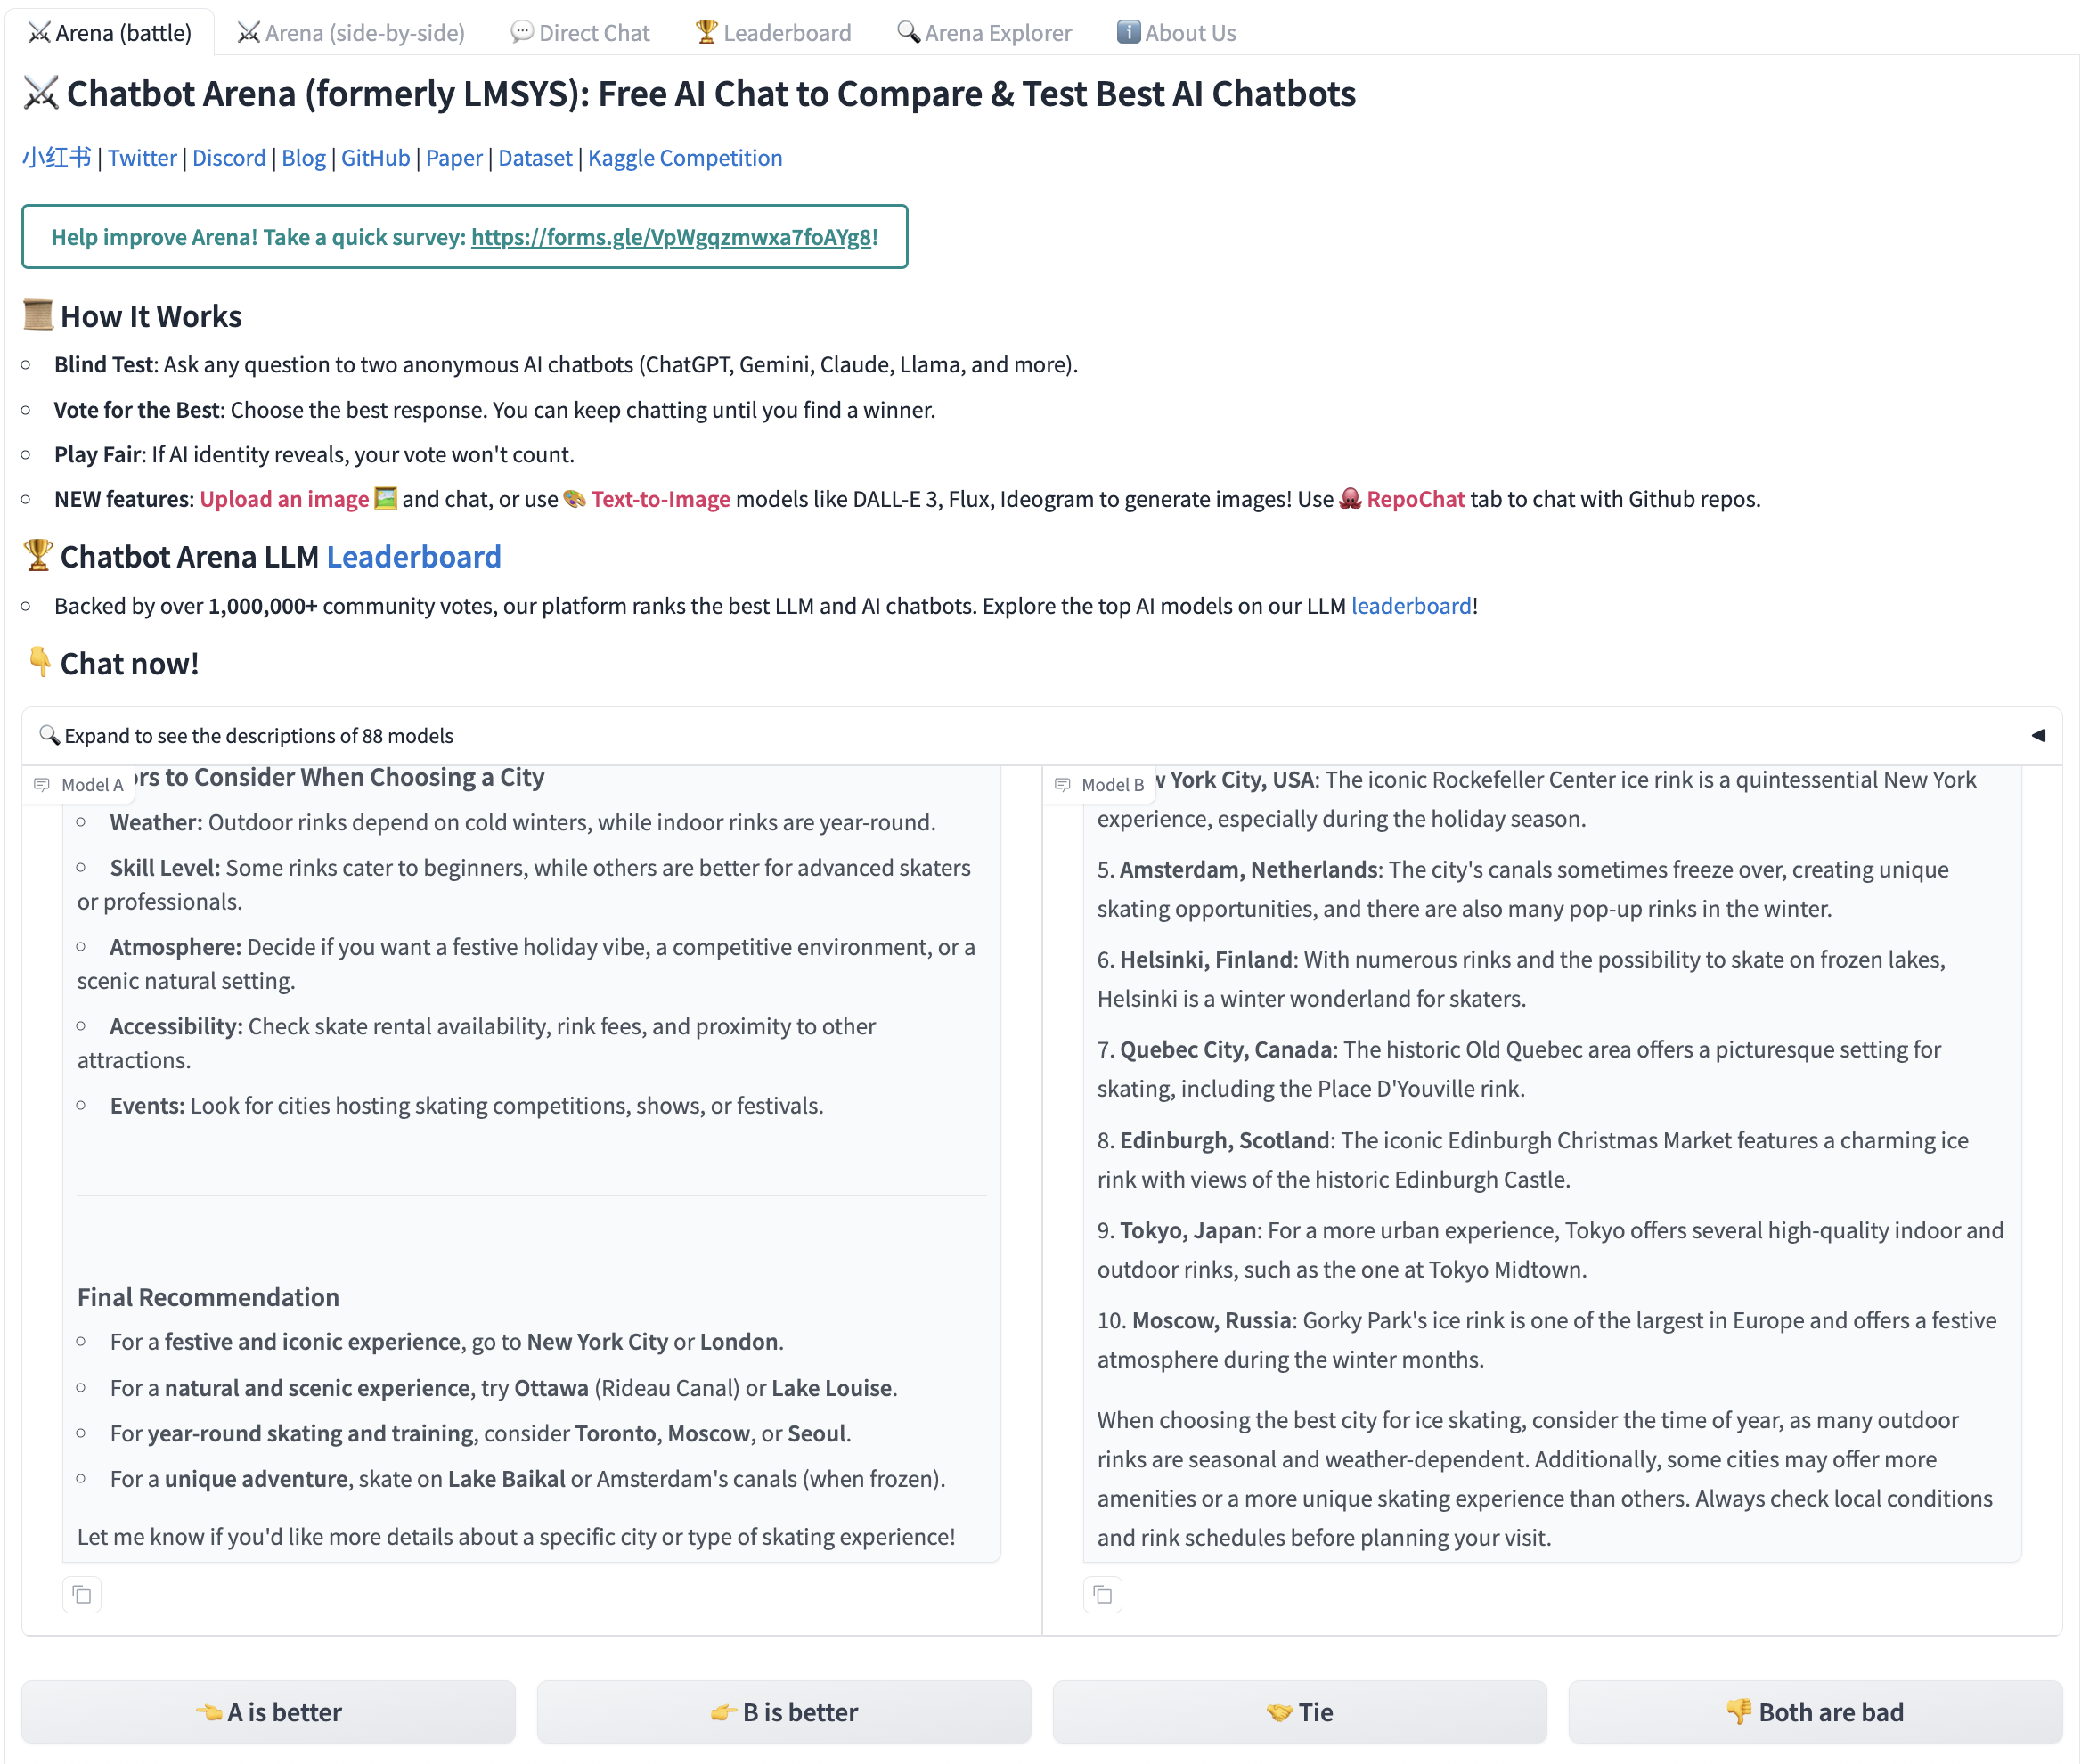
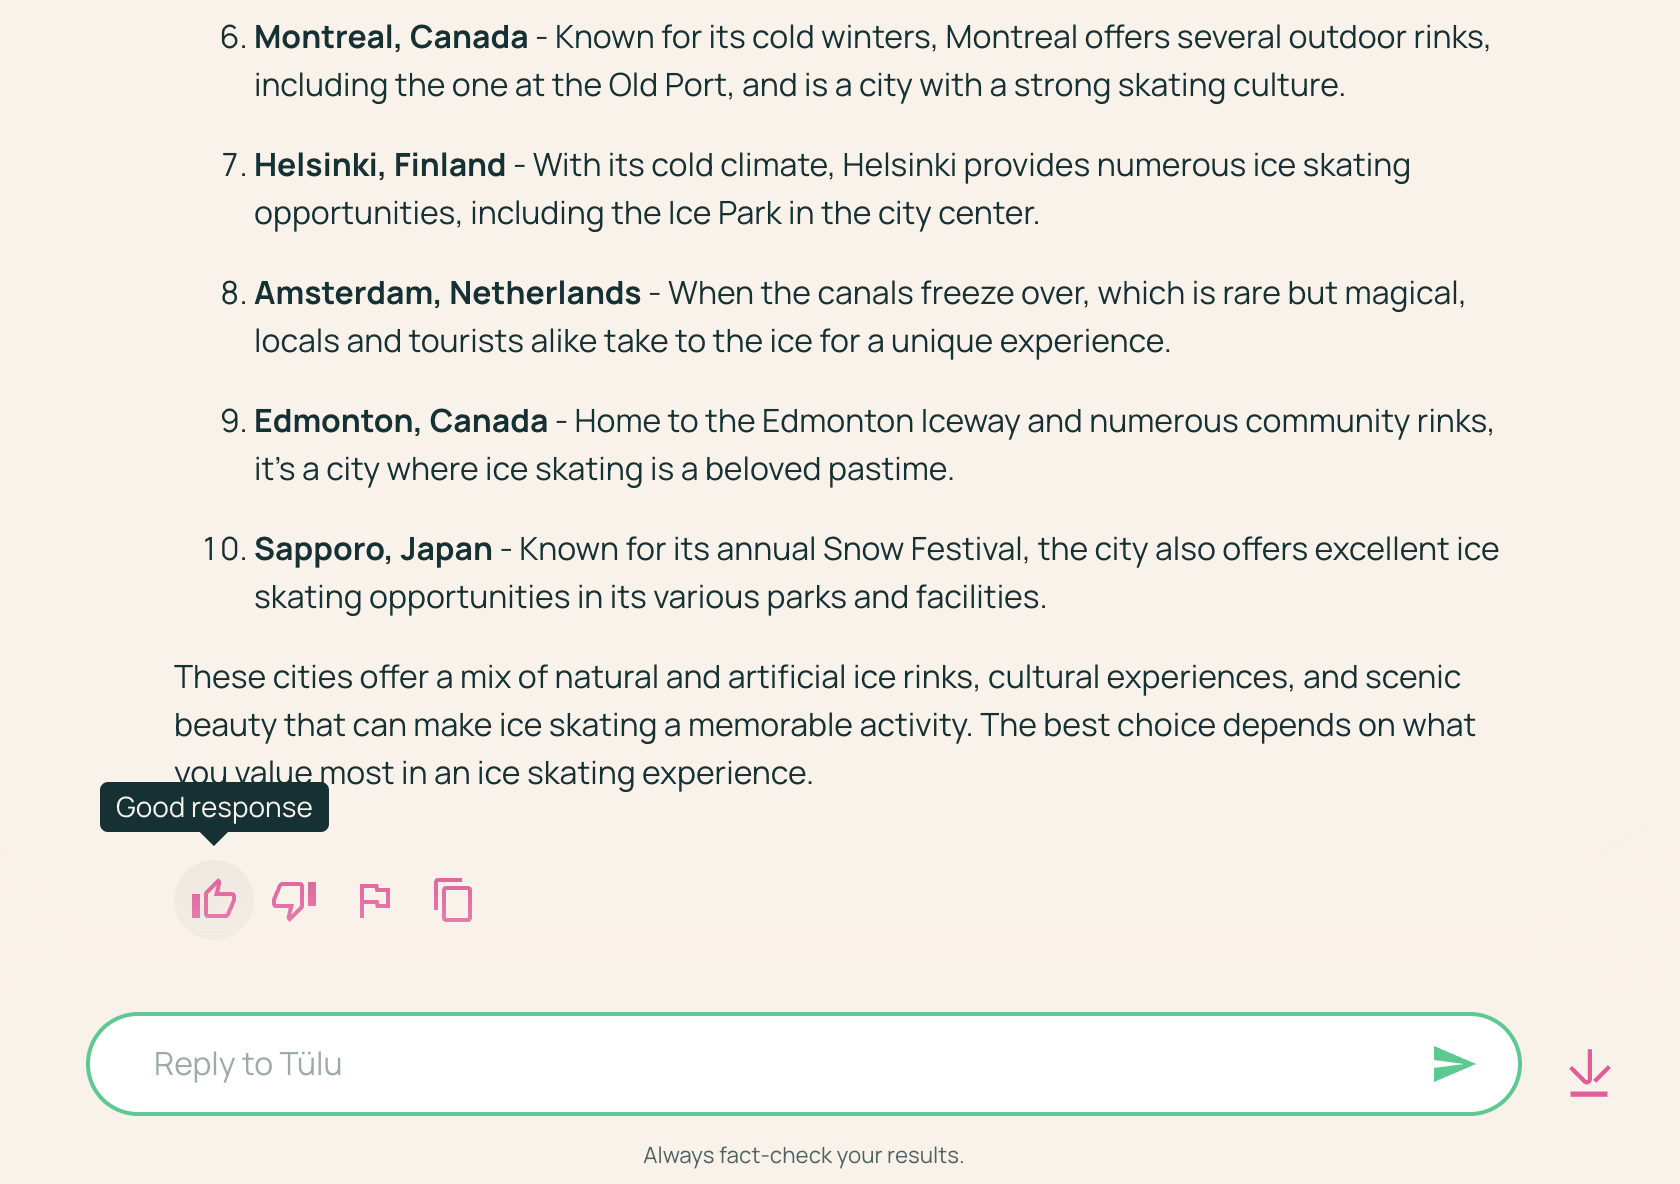
在实际部署的模型中,最常见的反馈收集方式之一是让用户对模型的具体回复给出正面或负面评价。 如下图Ai2 playground的例子,用“点赞”或“点踩”来收集偏好:
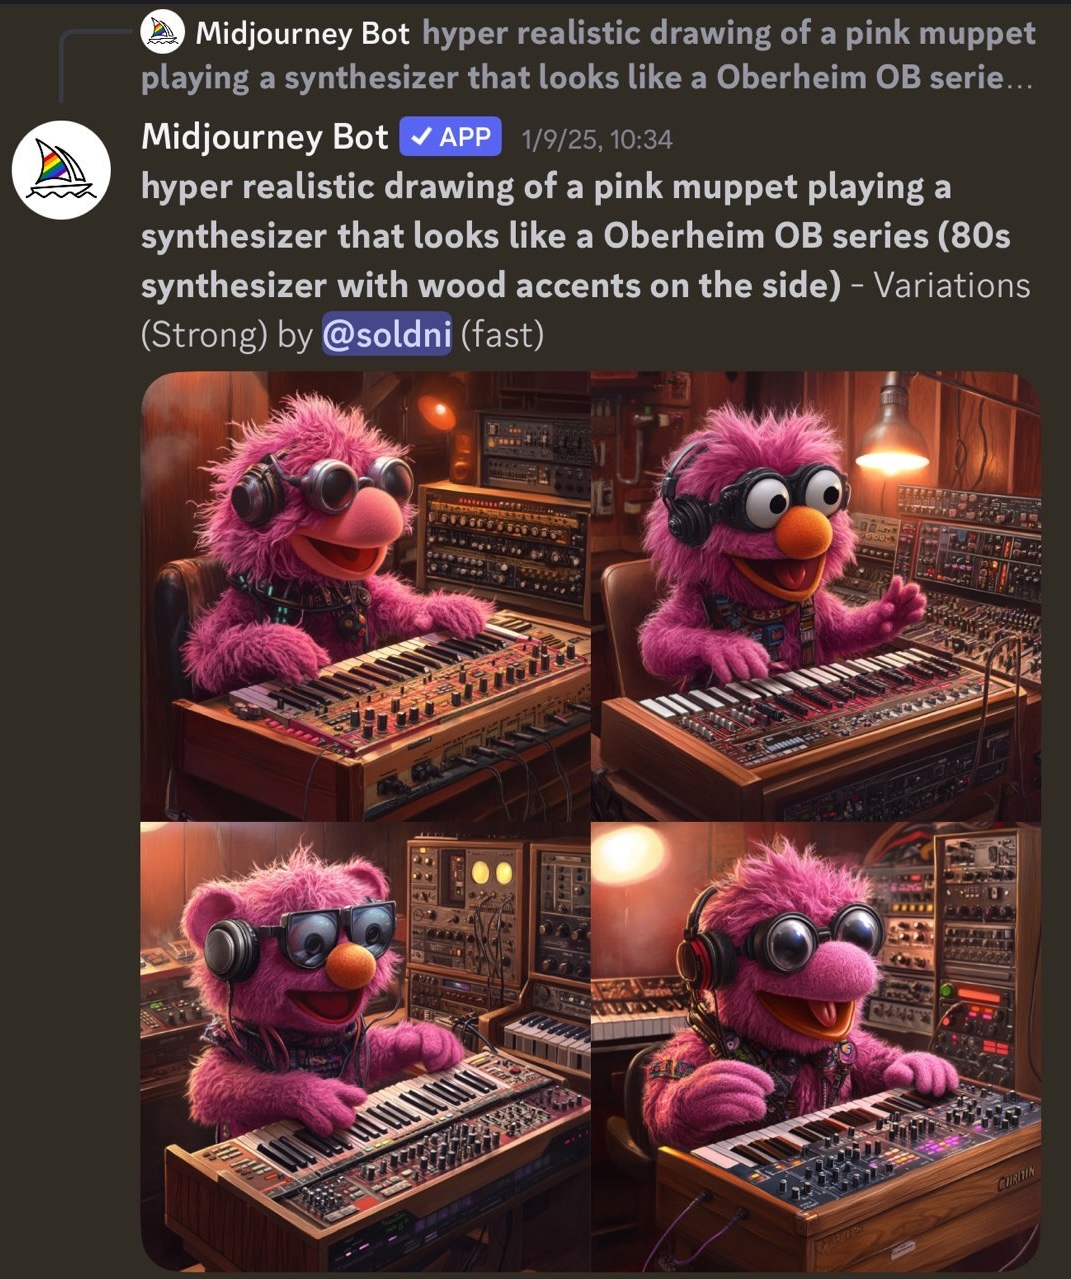
在非语言领域,类似原则同样适用,尽管本书不做重点讨论。 比如Midjourney等主流AI绘画平台,都会同时展示多个生成结果让用户选择,进而用这些选择数据对模型进行RLHF微调。 如下为Midjourney的界面示例:
排序 vs. 评分
收集偏好数据的最大决策之一,是采用“排序”(rankings,模型输出的相对排序)还是“评分”(ratings,对每个文本单独打分)。 业界普遍采用排序数据进行训练,但评分数据常作为元数据或在相关研究中被探索。
最常见的偏好收集方法是Likert量表 [4],即让用户对两个回复的优劣进行打分。 例如,5分Likert量表如下所示:
| A\(>>\)B | A\(>\)B | Tie | B\(>\)A | B\(>>\)A |
|---|---|---|---|---|
| 1 | 2 | 3 | 4 | 5 |
有些早期RLHF语言模型工作采用了8级Likert量表,细化了偏好层级 [2]。 偶数级量表可以避免出现“平局”:
| A\(>>>\)B | A\(>\)B | B\(>\)A | B\(>>>\)A | ||||
|---|---|---|---|---|---|---|---|
| 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 |
在[2]等工作中,这些多级偏好信息最终仍会被简化为二元信号用于奖励模型训练。
多轮数据
在实际操作中,如何解析和收集多轮对话数据(即包含多个相关prompt的对话)也是一个核心问题。 现实交互中,通常只对“最后一个”prompt收集偏好数据,但也存在对每一轮回复都给出偏好的场景。 如果每轮都给出偏好,后续对话通常会基于“被选中”的回复继续。 在训练时,常常将对话的每一轮都作为“单独的prompt”纳入训练数据,模型可以通过补全这些对话来学习。 这样可以有效将长对话拆解为多个训练样本,但需要谨慎处理,避免训练数据产生偏差。 目前还存在许多未解之谜,比如标注生成偏好的人是否应与设计prompt的人相同(以避免“迎合”现象),以及数据收集中其他难以控制的变量(灵感来自John Schulman的讨论)。 如果prompt设计者无法参与偏好标注,多轮对话的实时延续就很难实现——有时,偏好数据的prompt策划和回复对比其实是两种不同的问题(同时也涉及模型接口的持续维护)。 在训练过程中,通常会将对话历史中的前几轮对模型损失进行mask,具体可参考指令微调相关内容。
结构化偏好数据
在许多RLHF和后训练应用中,由于数据本身具备一定结构,偏好数据可以自动化生成——即某些领域可以自动判断正确与否或偏好。 比如在数学推理领域,正确答案可以直接作为选中回复,错误答案作为被拒回复。 又如在严格指令遵循评测(如IFEval [5]),prompt形式如下:
Write me a short poem about a goldfish. Start each sentence with the letter g.
这里,后半句就是约束条件,偏好数据可以通过包含约束的示例作为选中项来构建。 这类合成偏好数据的构建方式,是对同一任务分别用不同模型(或不同设置)生成两次,一次带约束、一次不带约束。
例如,分别用GPT-4.5-Preview生成如下内容:
Prompt: Write me a short poem about a goldfish. Start each sentence with the letter g.
Response: Golden swimmer, circling slow,
Gleaming scales in water’s glow.
Gentle fins dance softly by,
Gazing out with quiet eye.
Glass-bound world, a simple sphere,
Gliding calmly, free of fear.
Graceful turns in endless roam,
Goldfish finds a crystal home.
去掉约束条件(通常输出质量也会下降):
Prompt: Write me a short poem about a goldfish.
Response: In circles bright, the goldfish glides,
A spark of sun that gently rides
Through waters clear, in endless spins—
A golden whisper, scales like fins.Its world confined, yet vast within,
Each bubble breathed, a tale begins.
In silent waves, content to roam,
The goldfish dreams its bowl as home.
关键是,偏好数据的prompt要包含约束条件。 在学术以外的应用领域,基于归纳偏见的结构化偏好数据还有更多场景,这类数据已被证明能显著提升相关评测下的偏好微调效果 [6]。
其他方式
除了上述主流方法,还有许多尚未被广泛探索的RLHF反馈数据收集方式。 例如,可以用单个数据点配合方向性标签(如上文图 4的Ai2 playground例子),并结合专为单向信号设计的算法(如Kahneman-Tversk Optimization,KTO)[7]。 也有研究提出用更细粒度的反馈信号(如token级别 [8]),或用自然语言直接评价(如书写反馈 [9]),以获得更丰富的学习信号,但这也会带来更复杂的数据收集流程。
数据采购与合同
获取人类偏好数据是一项复杂且昂贵的工程。 以下内容描述了在行业高速发展期采购偏好数据的真实体验。 随着AI反馈数据比例的提升,这些流程未来会更加自动化和高效。
第一步是找到数据供应商(或自有标注员)。 就像抢购顶级Nvidia显卡一样,在AI热潮中,能提供高质量数据的厂商也是“资源有限”,谁有人脉谁先得。 如果你在AI圈有一定声誉,顶级数据公司会主动拉你入客户名单,以提升形象和未来合作空间。 通常,首批数据还有折扣,目的是让训练团队“上瘾”。
如果你是新入行者,可能很难快速拿到所需数据。 新兴数据公司往往只能承接被Scale AI等大厂拒绝的“尾单”,这也是他们启动营收的常规手段。
我多次听说数据公司在没有法律或财务威胁的情况下拒绝交付合同数据,甚至有些公司把我们列为客户做宣传,实际从未合作——追问时只说“不知道怎么回事”。 整个流程中可能遇到各种官僚或行政障碍,比如合同默认条款常常在细则中禁止数据开源。
合同敲定后,买方与数据方会就具体任务达成详细说明。 这些说明文档往往极其繁琐,包含大量细节、边界情况和优先级。 一个流行的公开数据说明示例是OpenAI为InstructGPT发布的指引 [10]。
不同领域的数据标注周期各不相同。 高需求领域如数学推理、编程等,必须提前数周锁定排期。 数据收集延误并不总能补救——Scale AI等公司管理标注团队的方式,类似AI研究机构调度算力集群。
一切谈妥后,数据收集阶段对后训练团队来说就是“高压期”。 所有基础设施、评测工具、数据使用与决策方案都必须提前准备好。
数据通常按周分批交付,后续批次会在合同期内陆续到来。 比如我们在HuggingFace采购on-policy模型的偏好数据时,交付周期为6周,前几周用于进一步校准,后几周则希望最大提升模型质量。
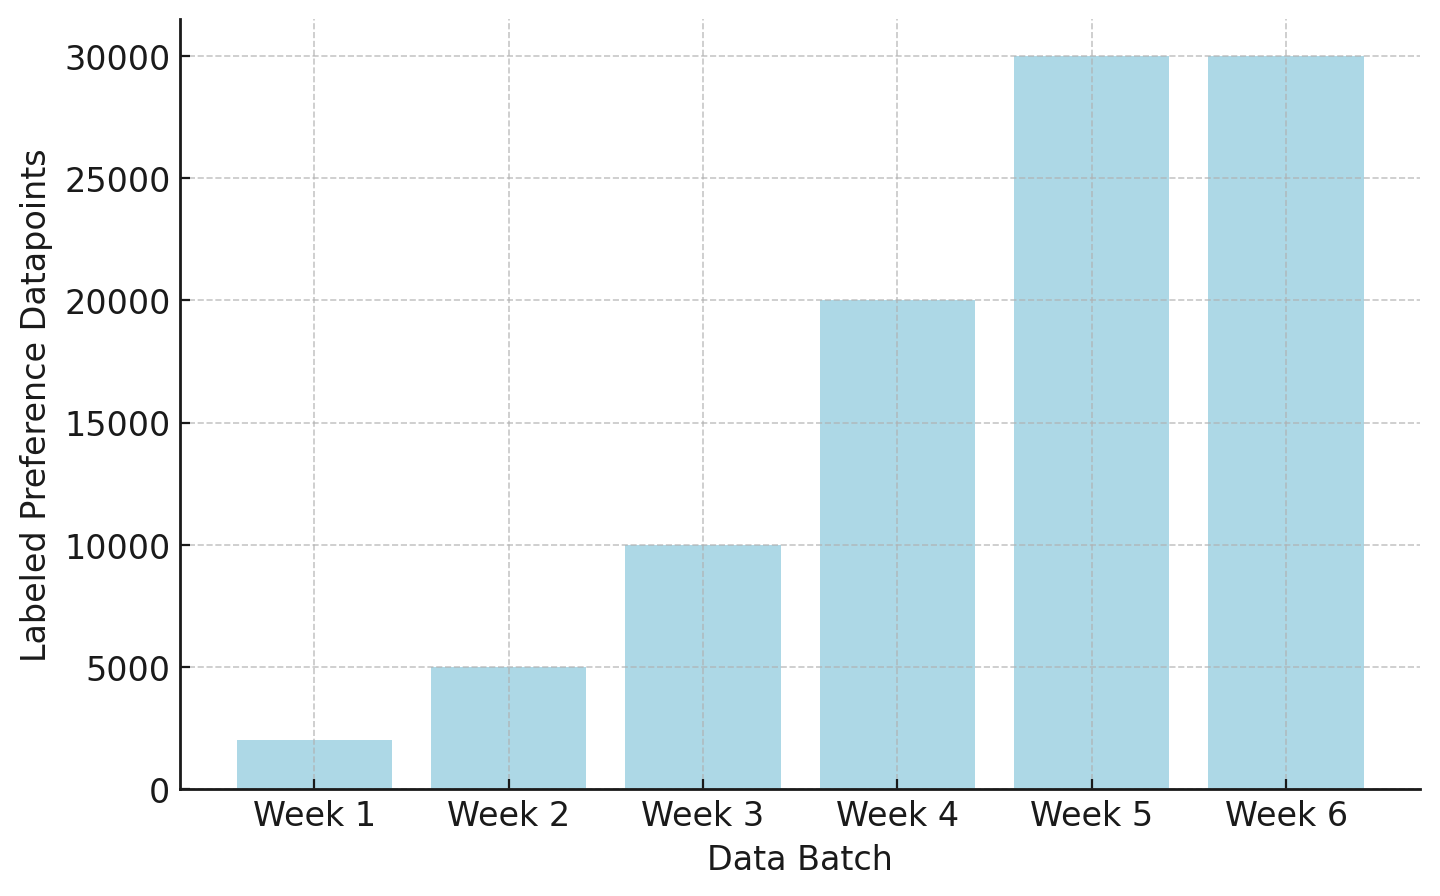
理想情况下,到第4、5周我们就能看到数据带来的模型提升。 有些前沿模型也提到类似流程,比如Llama 2数据收集的14个阶段 [11],但实际未必总能顺利进行。 我们在HuggingFace首次尝试用人类偏好做RLHF时,并没有做好充分准备,评测提升并不明显,最后几周不得不继续采集来自不自信模型端点的数据。
数据全部到位后,才有时间反思和改进模型。 通过供应商采购数据,最有效的方式是将其视为一个持续实现目标的过程,需要反复试验、高强度投入和专注。 事实上,花在这些数据集上的数百万美元中,可能有很大一部分“浪费”了,没进最终模型,但这就是行业代价。 能充分利用这类人类数据的组织并不多。
与合成数据的简单易得相比,这种体验让我不禁思考,未来十年这些数据公司的生存空间如何。
需要注意的是,这一节描述的并不适用于采购人类编写的指令数据,那类流程通常没有如此紧迫的时间压力。
模型中真的表达了这些偏好吗?
随着RLHF及相关方法的成熟,其最初“让模型对齐抽象人类偏好”的动机,逐渐演变为“让模型更好用”这一现实目标。 由于工业界RLHF流程高度闭源,我们很难直接衡量模型行为是否真的符合数据标注员在数据收集时的预期。 目前可用的审计工具很有限,比如OpenAI的Model Spec [12],它详细说明了他们希望模型做什么,但我们并不知道这些规范如何转化为数据收集实践。 随着行业和技术的成熟,这一领域值得持续关注。