训练概览
问题形式化
人类反馈强化学习(RLHF)的优化过程是在标准强化学习(RL)框架基础上发展而来的。 在RL中,智能体根据环境状态\(s\),从策略\(\pi\)中采样动作\(a\),以最大化奖励\(r\) [1]。 传统RL中,环境会根据转移函数或动态函数 \(p(s_{t+1}|s_t, a_t)\) 进行演化。 因此,在无限时域、折扣回报的情境下,RL智能体的目标是求解如下优化问题:
\[J(\pi) = \mathbb{E}_{\tau \sim \pi} \left[ \sum_{t=0}^{\infty} \gamma^t r(s_t, a_t) \right],\qquad{(1)}\]
其中\(\gamma\)为折扣因子(取值 \(0\leq\gamma<1\)),用于平衡即时奖励与未来奖励的重要性。 第11章将详细讨论优化该目标的多种方法。
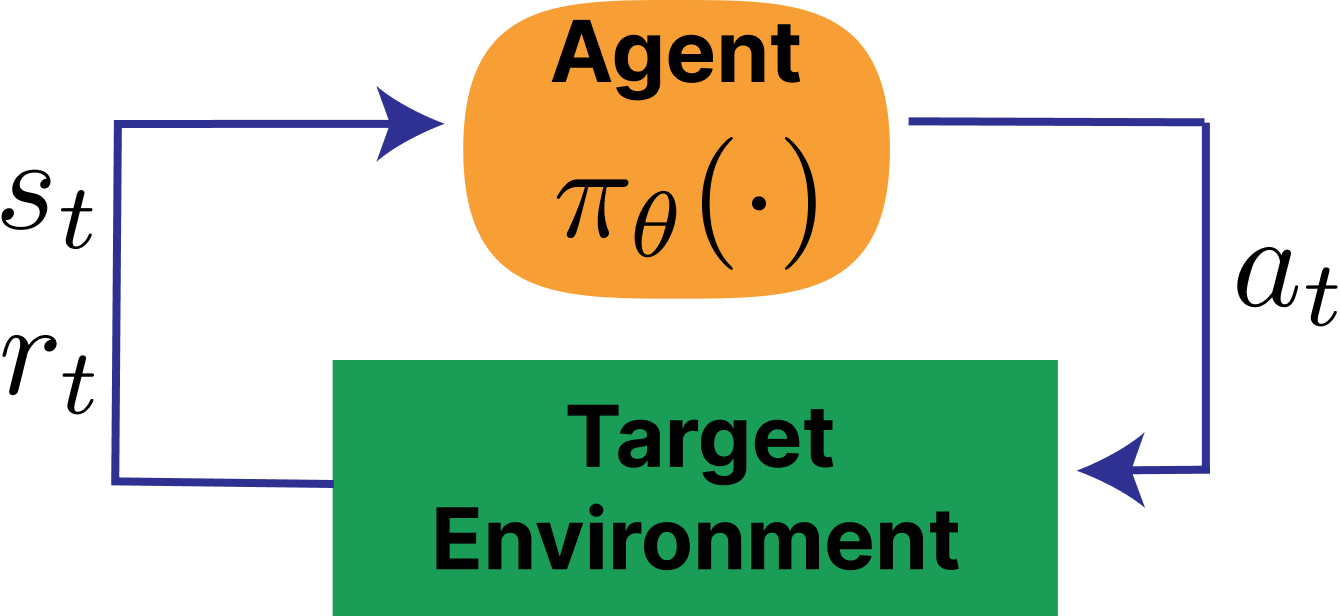
标准RL设置的调整
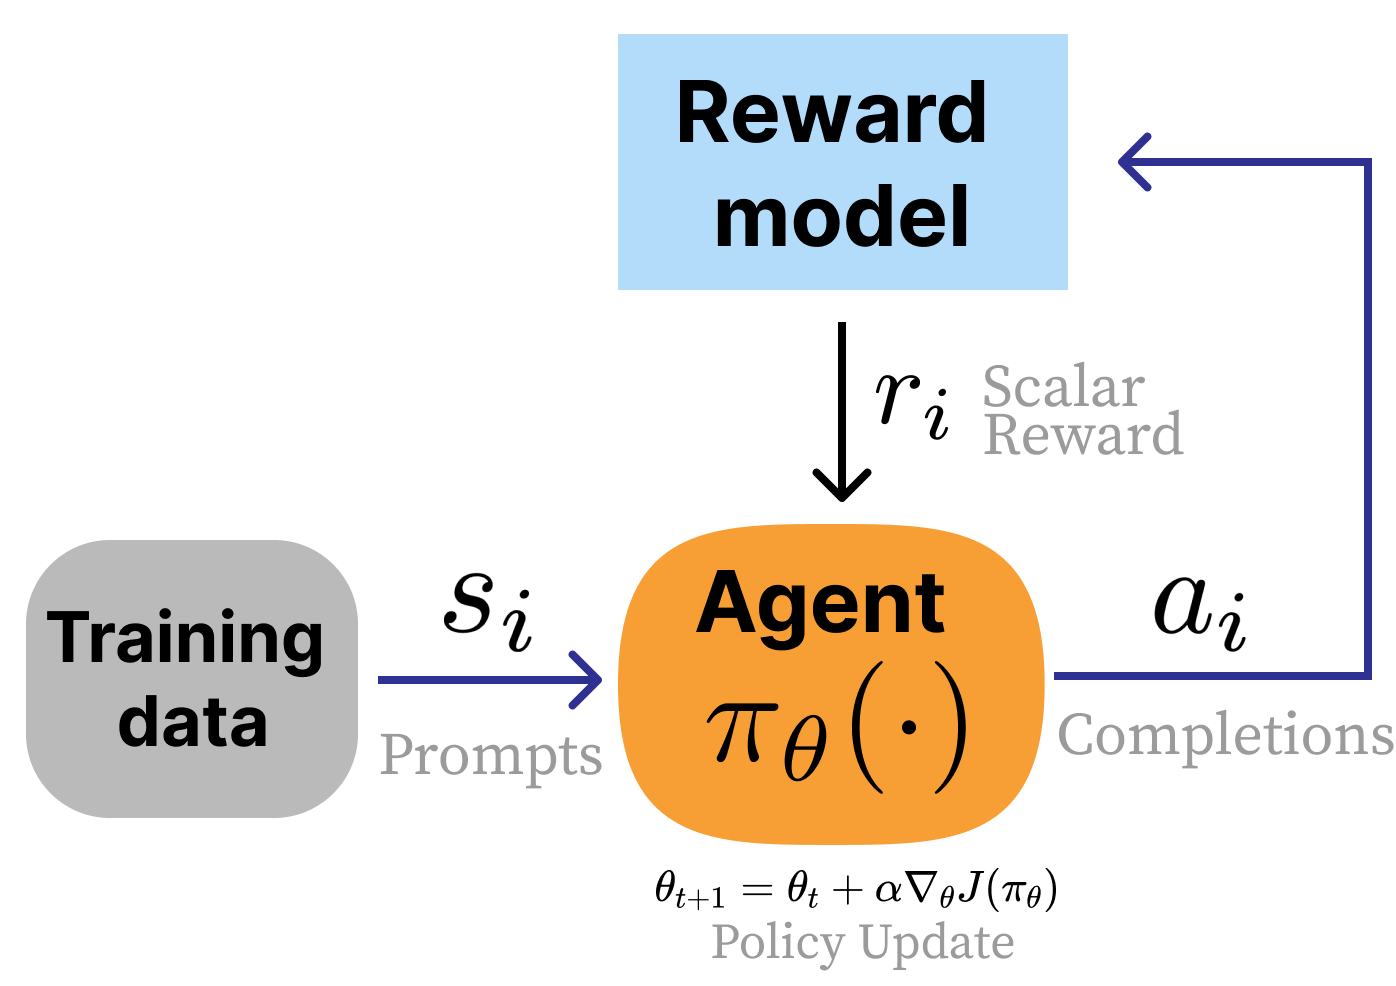
从标准RL到RLHF,核心有以下几个变化:
- 奖励函数被奖励模型替代。在RLHF中,使用一个学习得到的人类偏好模型 \(r_\theta(s_t, a_t)\)(或其他分类模型)来代替传统的环境奖励函数。这让设计者在方法和结果上拥有更高的灵活性和可控性。
- 单轮任务可建模为上下文 bandit:prompt 是上下文,完整回复是一个动作。但若以 token 为动作,状态仍随 token 拼接而转移;多轮对话或工具交互还包含外部环境的转移。
- 回答级奖励。RLHF通常将奖励分配给整条生成序列(即多个token组成的完整回复),而不是对每一步细致打分,这类似于bandit问题。
在上述单轮、回答级建模下,可省略时间步求和,但仍保留奖励模型。用 \(\theta\) 表示策略参数、\(\phi\) 表示奖励模型参数,目标为: \[J(\pi) = \mathbb{E}_{x\sim\mathcal{D},\,y\sim\pi_\theta(\cdot\mid x)}[r_\phi(x,y)].\qquad{(2)}\]
因此,虽然RLHF在优化器和问题设定上深受RL启发,但其具体动作实现与传统RL有很大不同。
优化工具
本书将详细介绍多种主流的RLHF优化技术。 后训练常用的工具包括:
- 奖励建模(第7章):训练一个模型来捕捉偏好数据中的信号,输出一个标量奖励,用于衡量未来文本的优劣。
- 指令微调(第9章):RLHF的前置步骤,通过模仿精选示例,让模型学会当前主流的问答交互格式。
- 拒绝采样(第10章):最基础的RLHF方法,用奖励模型筛选指令微调生成的候选补全,以模仿人类偏好。
- 策略梯度(第11章):RLHF经典案例中用于根据奖励模型信号优化语言模型参数的强化学习算法。
- 直接对齐算法(第12章):直接利用成对偏好数据优化策略,无需先训练中间奖励模型。
现代RLHF模型通常先进行指令微调,随后结合上述多种优化手段。
RLHF典型流程示例
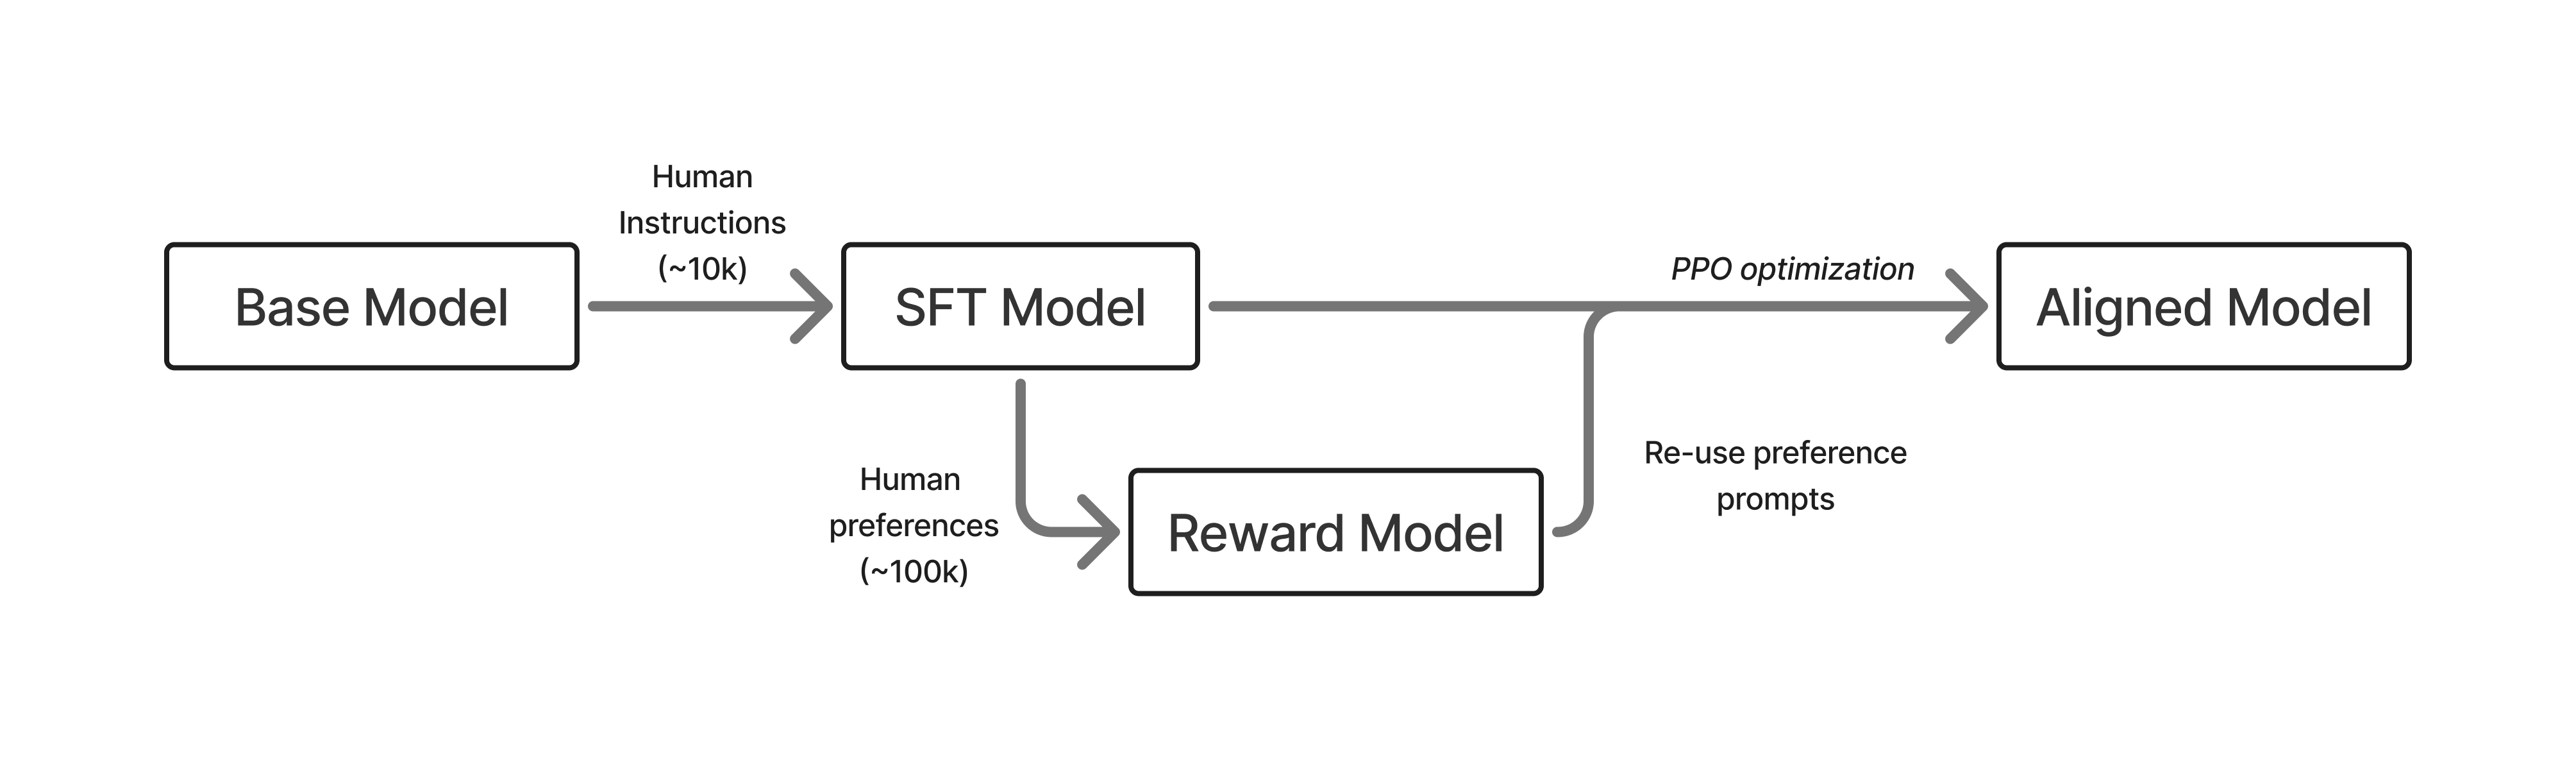
InstructGPT 等公开工作描述了经典的三阶段后训练流程;不能据此断言 ChatGPT 的完整训练细节 [2] [3] [4]。 在“基础”语言模型(即大规模网页文本上训练的next-token预测模型)之上,依次进行如下三步(见图 3):
- 指令微调(SFT):利用示范回答,让模型适应指令与问答格式。
- 奖励模型训练:比较同一 prompt 下的多个回答,学习偏好评分。成对数据比较的是回答,而不是两个 prompt。
- 策略优化:从训练 prompt 生成回答,再根据奖励模型与正则化信号更新策略。数据规模与来源依具体系统而定。
完成RLHF后,模型即可上线服务用户。这个流程是现代RLHF的基础,后续的流程在此基础上不断扩展,引入更多阶段和更多数据。
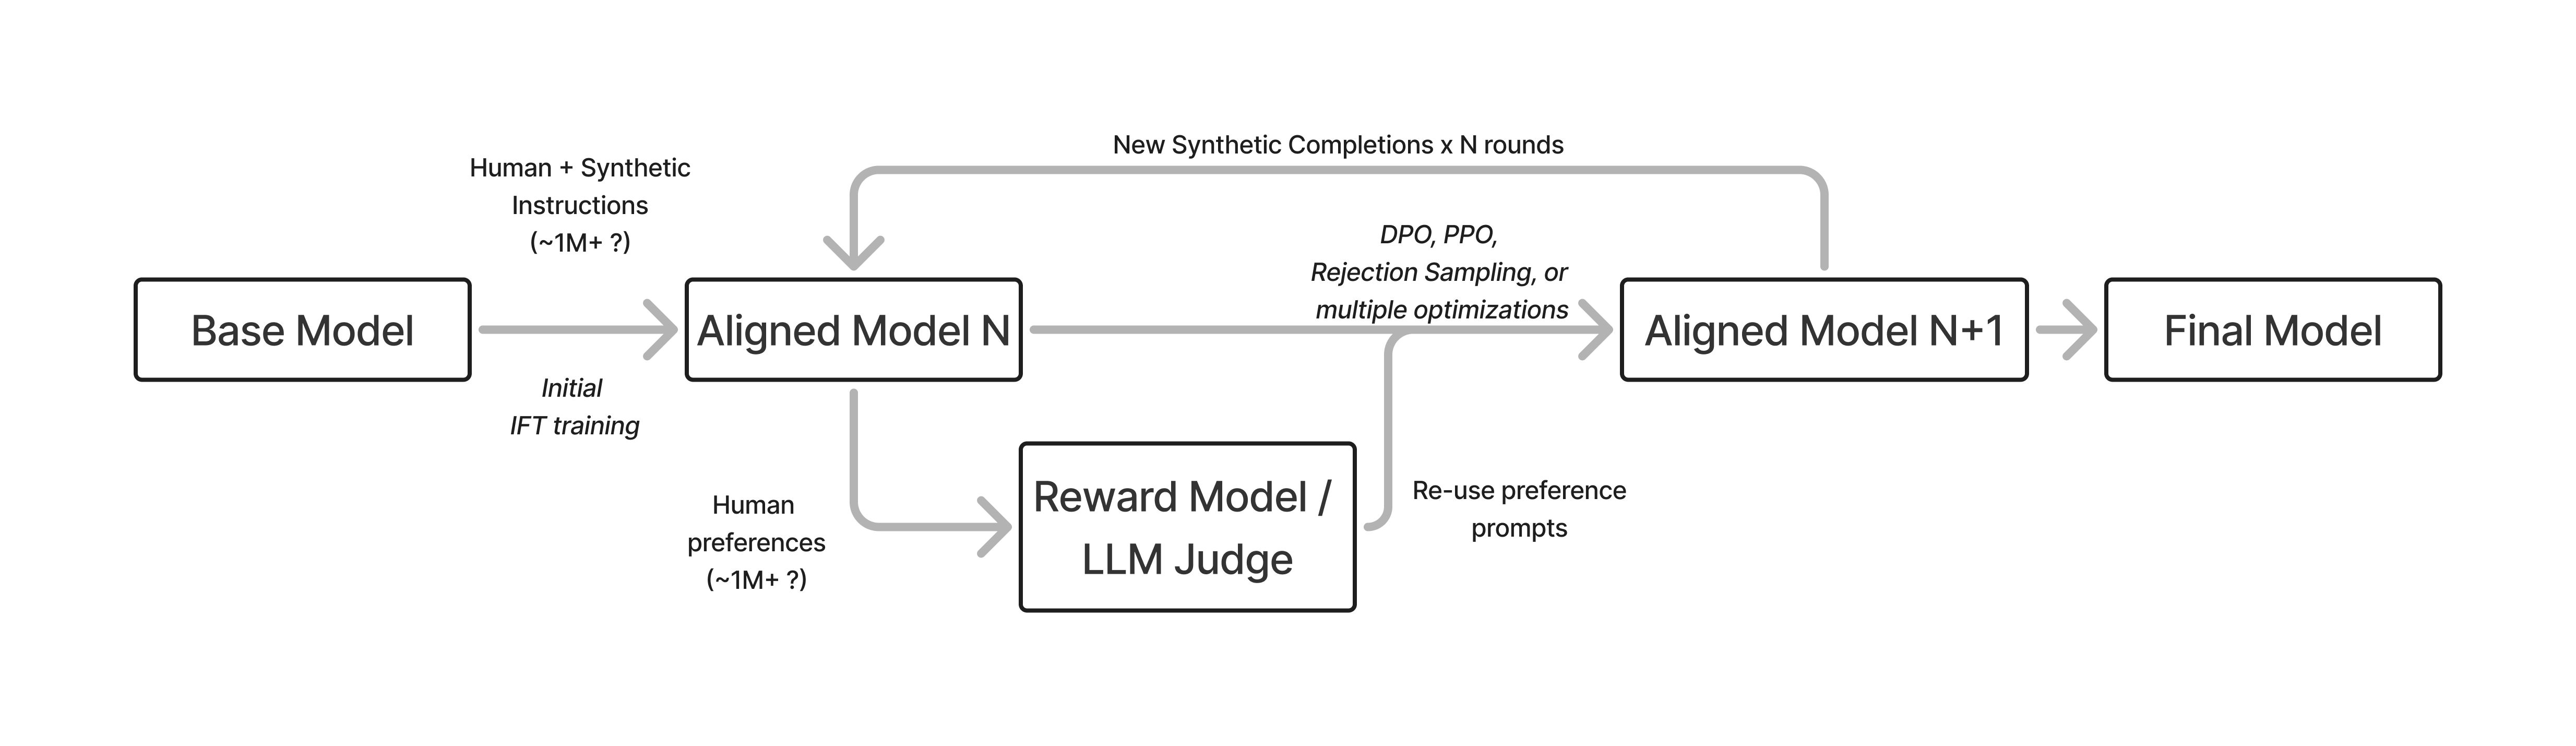
现代后训练流程通常涉及更多模型版本。 如下图 4所示,模型在收敛前要经历多轮训练迭代。
微调与正则化
RLHF是在强大的基础模型上进行的,因此需要控制优化过程,防止模型偏离初始策略太远。 为了在微调阶段取得良好效果,RLHF通常采用多种正则化方法来约束优化过程。 最常见的做法是在优化目标中加入距离惩罚项,用于衡量当前RLHF策略与初始策略之间的差异:
\[J(\pi) = \mathbb{E}_{x\sim\mathcal{D}}\!\left[\mathbb{E}_{y\sim\pi_\theta(\cdot\mid x)}r_\phi(x,y) - \beta D_{\mathrm{KL}}\!\left(\pi_\theta(\cdot\mid x)\|\pi_{\mathrm{ref}}(\cdot\mid x)\right)\right].\qquad{(3)}\]
在这个公式下,RLHF训练的一个重要研究方向就是如何合理利用“KL预算”,即控制模型与初始模型的距离。 更多细节可参考第8章“正则化”部分。