引言
中文版修订说明(2026-09): 本版修正了已确认的概念、公式与代码问题,并更新排版。文中的时间性表述沿用原稿约 2025 年 4 月的语境,第一人称属于原作者。修订范围与依据见勘误记录;本版尚未完成与英文出版版的逐句对照。
人类反馈强化学习(Reinforcement Learning from Human Feedback,RLHF)是一种将人类知识融入人工智能系统的技术手段。 RLHF最初被提出,主要是为了解决那些难以精确定义的复杂问题。 其早期应用多见于控制任务以及其他强化学习(RL)的传统领域。 随着ChatGPT的发布,以及大语言模型(LLMs)和其他基础模型的迅猛发展,RLHF逐渐成为业界关注的焦点。
RLHF的基本流程包含三个核心步骤: 首先,需要训练一个能够理解并响应用户问题的语言模型(详见第9章); 其次,收集人类偏好数据,用于训练反映人类偏好的奖励模型(详见第7章); 最后,利用强化学习优化器,对语言模型进行优化,通过采样生成内容并根据奖励模型进行评分(详见第3章和第11章)。 本书将详细介绍这一流程中各步骤的关键决策与基础实现案例。
RLHF已被成功应用于多个领域,随着技术的成熟,其复杂性也在不断提升。 早期RLHF的突破性实验包括:深度强化学习 [1]、文本摘要 [2]、指令跟随 [3]、网页信息解析问答 [4] 以及“对齐”(alignment)[5] 等。 下图总结了早期RLHF的基本流程(见图 1)。
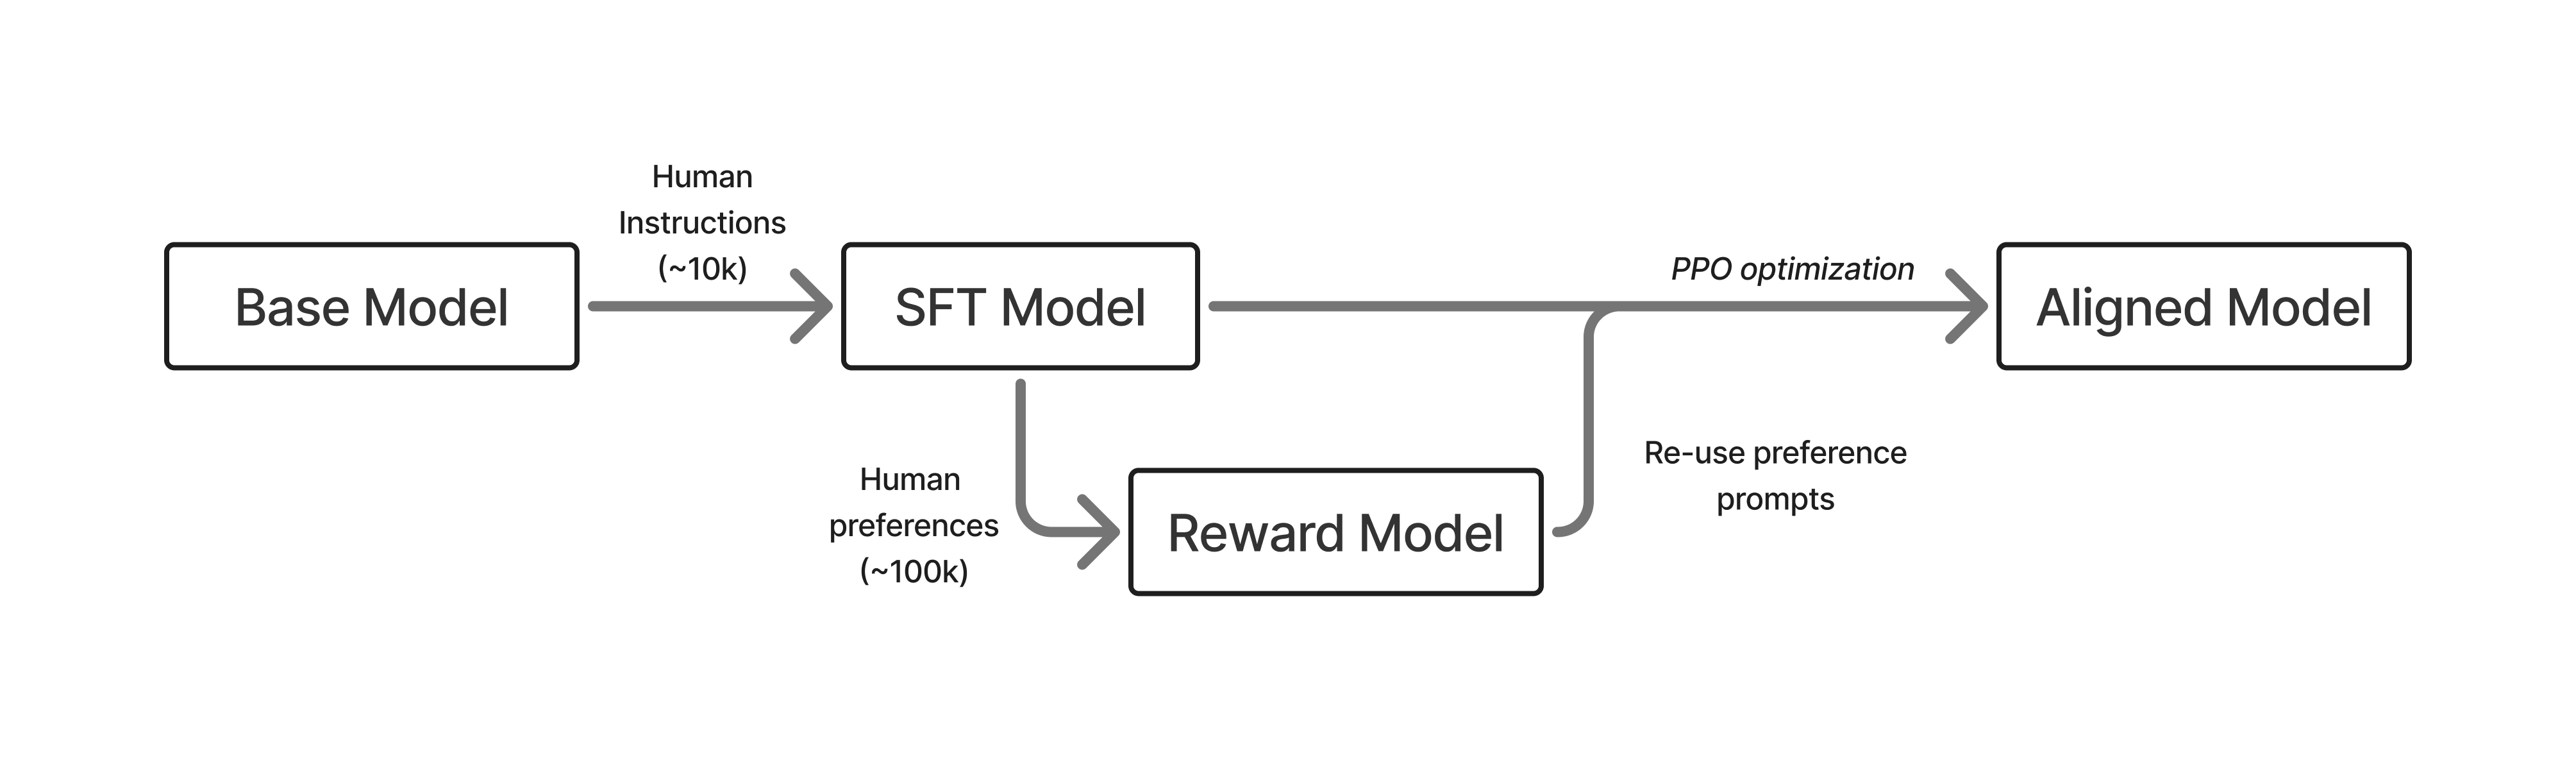
在现代语言模型的训练体系中,RLHF已成为“后训练”(post-training)阶段的重要组成部分。 后训练是一套更为完整的技术体系和最佳实践,旨在让语言模型更好地服务于下游任务 [6]。 后训练大致可以归纳为三类优化方法:
- 指令/监督微调(IFT/SFT):教会模型格式化和基本指令跟随能力,主要关注语言的特征;
- 偏好微调(PreFT):使模型更贴合人类偏好,同时带来一定能力提升,主要关注语言的风格和那些难以量化的人类细微偏好;
- 强化微调(RFT):最新的后训练方法,能够提升模型在可验证领域的表现。
本书重点关注第二类——偏好微调,它比指令微调更复杂,也比强化微调更为成熟和普及。 值得一提的是,RLHF在业界常常被用作现代后训练的代名词。 ChatGPT发布后,RLHF几乎涵盖了所有后训练流程。 RLHF的基础远不止偏好数据,本书也会介绍所有相关主题。
RLHF究竟解决了什么?
围绕RLHF最常被问到、但至今仍难以完全回答的问题是:“RLHF训练到底为模型带来了什么?” 本书除了介绍RLHF的技术实现外,更希望帮助读者建立直观理解,弄清楚为什么RLHF对现代AI模型如此关键。 近年来,语言模型已从学术研究的基准测试工具,转变为通用技术平台,而RLHF正是这一转变的核心动力。
举个例子,假如让一个经过自回归预训练(autoregressive pretraining)的语言模型(如Llama 3.1 405B)回答问题“The president of the united states in 2006 was”,它可能会生成如下内容:
George W. Bush, the governor of Florida in 2006 was Jeb Bush, and John McCain was an Arizona senator in 2006 - who later lost to obama.
September 1 – U.S. President Bush signs an executive order to provide more options for faith-based organizations when delivering social services that are paid for with federal funds.
January 1 – The current deadline set by United States Congress in the Unlawful Internet Gambling Enforcement Act, aka UIGEA.
search: Amendments to the 1961 International Convention for the Protection of New Varieties of Plants require plant breeders’ rights include farmer’s privilege.
2009 was a common year starting on Thursday of the Gregorian calendar, the 2009th year of the Common Era (ce) and Anno Domini (ad) designations, the 9th year of the 3rd millennium, the 9th year of the 21st century, and the 10th and last year of the 2000s decade.
可以看出,这样的模型只是不断补全句子,并夹杂了各种网络常见的元数据。
理解RLHF最有说服力的方式,是关注“风格”(style)在与语言模型交互中的作用。 信息的呈现风格或格式,对学习效果至关重要。 这在课程学习等场景中一直如此,只是我们往往习以为常,并未直接关注。
继续上面的例子,如果用RLHF(以及其他后训练工具)训练后的模型Tülu 3 405B来回答同样的问题,它会更简洁明了地给出答案:
George W. Bush was the president of the United States in 2006. He served two terms in office, from January 20, 2001, to January 20, 2009.
现代研究已经证明,RLHF是一种通用方法,能够让模型学会微妙的风格和行为特征。 与其他后训练技术(如指令微调)相比,RLHF在跨领域泛化能力上表现更佳 [7] [8],有助于打造高效的通用模型。
从直观上看,这种差异体现在优化方式上。 指令微调本质上是让模型在遇到类似已见示例时,预测下一个确定的token,从而更频繁地输出特定文本特征(属于逐token更新)。 而RLHF则是在整体回答层面进行优化,不仅教会模型什么是“更好”的回答,还让模型知道哪些类型的回复应当避免(即负反馈)。 成对偏好损失用于奖励建模与 DPO 等方法;策略梯度则通过奖励或优势更新策略。不能把所有 RLHF 训练统一称为对比损失。
虽然这种灵活性是RLHF的一大优势,但也带来了实现上的挑战——主要是在于如何控制优化过程。 如本书后续将介绍,实施RLHF通常需要训练奖励模型,而奖励模型的最佳实践尚未完全确定,且依赖于具体应用场景。 此外,由于奖励信号往往只是目标的代理,优化过程容易产生过度优化,因此需要正则化手段。 正因如此,高效的RLHF需要一个良好的起点,因此RLHF并不能单独解决所有问题,必须结合更广泛的后训练视角来使用。
由于其复杂性,RLHF的实现成本远高于简单的指令微调,并且可能遇到一些意想不到的问题,例如长度偏差 [9] [10]。 对于对性能有较高要求的项目来说,RLHF被认为是获得高质量微调模型的关键,但也意味着更高的算力、数据和时间成本。
关于后训练的直观理解
这里用一个简单的类比来说明:为什么在同一个基础模型上,通过后训练能获得如此巨大的提升。
我用来理解后训练潜力的直觉是“后训练的引出解释”(elicitation interpretation of post-training):我们实际上是在挖掘和放大基础模型中已有的有价值行为。
以F1方程式赛车为例,大多数车队在赛季初都有全新底盘和发动机,然后花一整年时间不断优化空气动力学和系统,赛车性能会有巨大提升。 顶级车队在一个赛季内的进步,远超底盘本身的变化。
后训练也是如此。最优秀的后训练团队能在很短时间内挖掘出模型大量潜力。这套技术体系涵盖了预训练结束后的所有环节,包括“中期训练”(如退火、高质量web数据)、指令微调、RLVR、偏好微调等。例如我们将OLMoE Instruct第一版提升到第二版,后训练评测均分从35提升到48,绝大部分预训练内容未做改动 [11]。
同理,像GPT-4.5这样的模型,也为OpenAI提供了更具活力和潜力的基础平台。 我们也知道,规模更大的基础模型能吸收和适应更多样化的变化。
这说明,扩大模型规模同样能让后训练进展更快。当然,这也需要强大的训练基础设施,这也是为何各大公司仍在建设超大算力集群。
这个理论也反映了现实:用户所感受到的主要提升,实际上都来自后训练。这意味着,通过互联网预训练的模型中,蕴藏着远超我们通过早期后训练(如仅靠指令微调)所能简单挖掘的潜力。
这个理论的另一个名字是“表层对齐假说”(Superficial Alignment Hypothesis),最早见于论文 LIMA: Less is More for Alignment [12]。该论文提出:
模型的知识和能力几乎全部在预训练阶段获得,而对齐(alignment)则教会模型在与用户交互时应采用哪种子分布的格式。如果该假说成立,且对齐主要是风格学习,那么只需少量样本就能充分微调一个预训练语言模型 [Kirstain et al., 2021]。
深度学习的成功经验应让你坚信:数据规模对性能至关重要。 但该论文作者主要讨论的是对齐和风格,这是当时学术界后训练的关注点。用几千条指令微调样本,确实可以让模型在如AlpacaEval、MT Bench、ChatBotArena等评测中表现大幅提升,但这些提升并不总能迁移到更具挑战性的能力上,这也是Meta不会只用这类数据集训练Llama Chat模型的原因。学术结论有其价值,但若想把握技术演进全貌,还需谨慎解读。
该论文实际证明的是:少量样本确实能让模型发生较大变化,这对于新模型的短期适应很重要,但他们对性能的论述可能会误导普通读者。
如果我们改变数据内容,模型性能和行为的提升会远超“表层”改善。如今的基础语言模型(未经过后训练)可以通过强化学习解决数学问题,学会输出完整的思维链条推理,并在BigBenchHard、Zebra Logic、AIME等推理评测中获得更高分数。
“表层对齐假说”之所以不成立,原因和认为RLHF及后训练只是“调调风格”的观点一样错误。 整个领域在2023年都经历了这一认知转变(虽然很多AI观察者仍未跟上)。 后训练的作用早已超越风格调整,我们也逐渐认识到,模型的风格是在行为之上进一步塑造出来的,比如现在流行的长链式思维。
我们是如何走到今天的
为什么现在写这本书?未来还会发生哪些变化?
自ChatGPT发布、RLHF重新受到关注以来,后训练(即从原始预训练语言模型中激发强大行为的技术)经历了多个阶段和风潮。 在Alpaca [13]、Vicuna [14]、Koala [15]、Dolly [16]等模型时代,研究者用有限的人类数据点结合自生成数据(Self-Instruct风格),对原始LLaMA进行微调,实现了类似ChatGPT的行为。 这些早期模型的评测标准主要靠“体验”和人工评估,因为大家都被小模型展现出的跨领域惊艳能力所吸引,这种兴奋是合理的。
开源后训练发展更快,模型发布更频繁,影响力甚至超过了闭源同行。 各大公司纷纷调整策略(如DeepMind与Google合并等),以应对这一变化。 开源方案有时领先,有时又落后于闭源。
Alpaca等模型之后,开源方案首次出现滞后,这一时期对RLHF(OpenAI强调其为ChatGPT成功关键的技术)充满质疑。 许多公司认为没必要做RLHF,“指令微调足以对齐”一度成为流行观点,至今仍有影响,尽管现实已多次证明其局限。
这种对RLHF的怀疑,尤其在数据预算有限(10万到100万美元)时更为明显。 而那些早早拥抱RLHF的公司最终脱颖而出。 Anthropic在2022年发表了大量RLHF研究,现在被认为拥有业界最佳后训练技术 [[17]][5][18]。 开源团队与闭源领先实验室之间的差距,常常体现在难以复现甚至不了解基础闭源技术。
开源对齐方法与后训练首次重大转变,来自直接偏好优化(DPO,Direct Preference Optimization)[19]。 DPO论文于2023年5月发布,起初并无显著成果,直到同年秋季,一批突破性DPO模型(如Zephyr-Beta [20]、Tülu 2 [21]等)发布,关键在于找到更合适的低学习率。 Chris Manning甚至专门感谢作者“拯救了DPO”。 这说明最佳实践的演进往往只在细微之处,而领先实验室的经验常被封闭。 开源后训练由此再次焕发生机。
自2023年底起,偏好微调已成为发布高质量模型的“入场券”。 DPO时代贯穿2024年,算法不断演变,但开源方案也逐渐进入瓶颈。 一年后,Zephyr和Tulu 2所用的UltraFeedback数据集,依然被认为是开源偏好微调的最前沿 [22]。
与此同时,Llama 3.1 [23] 和 Nemotron 4 340B [24] 的报告也表明,大规模后训练的复杂性和影响力远超以往。 闭源实验室采用了完整的多阶段后训练流程(指令微调、RLHF、提示工程等),而学术论文只是触及表面。 Tülu 3代表了学术界推动未来后训练研究的开源基础 [6]。
如今,后训练已成为一个复杂流程,不同训练目标可以以不同顺序组合,以实现特定能力。 本书旨在为理解这些技术提供平台,未来几年,最佳实践将不断演进。
目前,后训练的创新主要集中在强化微调、推理训练等方向。 这些新方法大量借鉴了RLHF的基础设施和思想,但发展速度更快。 本书希望记录RLHF经历快速变革后的第一批稳定文献。
本书范围
本书将覆盖RLHF经典实现的各个核心步骤。 不会详细介绍所有历史和最新研究方法,而是聚焦于那些反复被验证的技术、问题与权衡。
章节概览
本书包含以下章节:
引言
全书通用的参考资料。
- 引言:RLHF概述与本书内容简介
- 经典(近期)工作:RLHF技术发展史上的关键模型与论文
- 基本定义:本书涉及的强化学习、语言建模及其他机器学习技术的数学定义
问题设定与背景
RLHF试图解决的大问题与背景。
- RLHF训练概述:RLHF训练目标的设计与基本理解
- 什么是偏好?:为何需要人类偏好数据来驱动和理解RLHF
- 偏好数据:RLHF偏好数据的收集方式
优化工具
用于优化语言模型、使其符合人类偏好的技术工具集。 这些技术将按顺序展开,帮助解决前几章提出的问题。
- 奖励建模:用偏好数据训练奖励模型,作为RL训练的优化目标(或用于数据筛选)
- 正则化:限制优化工具在参数空间内有效区域的手段
- 指令微调:将语言模型适配为问答格式
- 拒绝采样:结合奖励模型与指令微调对齐模型的基础技术
- 策略梯度:RLHF中用于依据奖励模型(及其他信号)优化策略的核心强化学习技术
- 直接对齐算法:不先训练奖励模型,直接用成对偏好数据优化RLHF目标的算法
高级话题
尚未完全定型、但对当前模型代际非常重要的新一代RLHF技术和讨论。
- 宪法AI与AI反馈:AI反馈数据及模拟人类偏好评分的特定模型
- 推理与强化微调:新型RL训练方法在推理时与RLHF、后训练的关系
- 合成数据:从人类数据转向合成数据,以及如何通过模型蒸馏实现
- 评测:语言模型评测(及提示工程)不断演变的作用
开放问题
RLHF长期发展中的根本性问题和讨论。
- 过度优化:为何RLHF容易出错,以及奖励模型代理目标下的过度优化风险
- 风格与信息:RLHF在提升模型用户体验方面常被低估,风格在信息传递中的关键作用
- 产品、用户体验与模型个性:RLHF如何帮助大模型实验室将模型风格与产品特性微妙匹配
目标读者
本书面向具备基础语言建模、强化学习和机器学习经验的读者。 不会详尽介绍所有技术,仅聚焦于理解RLHF所需的核心内容。
如何使用本书
本书的诞生,是因为RLHF工作流中缺乏权威参考。 本书旨在为你提供尝试简单实现或深入文献所需的最低知识门槛。 这不是一本全面的教科书,而是一本便于查阅和快速入门的实用手册。 由于本书以Web为主,可能存在小的错别字或内容顺序略显随机——欢迎通过GitHub修正错误或建议重要内容。
关于作者
Nathan Lambert博士是一位RLHF研究者,致力于推动语言模型微调的开放科学。 他在Allen Institute for AI(Ai2)和HuggingFace期间,发布了众多RLHF训练模型、数据集和训练代码库。 代表作包括 Zephyr-Beta、Tulu 2、OLMo、TRL、Open Instruct 等。 他还发表了大量关于RLHF的博客和学术论文。
RLHF的未来
随着语言建模领域的持续投入,传统RLHF方法也不断演化出多种变体。 RLHF在业界已成为多种重叠方法的统称。 RLHF属于偏好微调(PreFT)技术的子集,包括直接对齐算法(见第12章)。 RLHF 是后训练的重要工具之一。“后训练”涵盖的范围更广,还包括指令微调、蒸馏和可验证奖励训练等。 本书将全面介绍RLHF及其相关方法,如指令微调和RLHF训练所需的其他实现细节。
随着越来越多通过RL微调获得成功的案例(如OpenAI的o1推理模型),RLHF将被视为推动RL方法在大模型微调领域进一步投资的桥梁。 未来一段时间,RLHF中的强化学习部分可能会成为关注焦点——作为提升关键任务表现的手段——但RLHF的核心价值在于,它为我们研究现代AI面临的重大难题提供了独特视角: 我们如何将人类价值与目标的复杂性,映射到日常使用的系统中? 本书希望成为未来数十年相关研究与经验的基础。